一张表看懂 2026 年主流大模型的架构选择
从 Kimi K2.5 到 Qwen3.8,我把 39 个主流开源模型的 FFN、注意力、归一化、位置编码方案整理成一张对比表;每个模型条目附主要公开来源,相关技术另列论文和核对说明。
今年 1 月到 8 月,开源大模型迎来一波密集发布:Kimi K2.5、Qwen3.5、DeepSeek V4、GLM-5、Gemma 4、Nemotron 3,随后 Kimi K3、MiniMax-M3、GLM-5.2/5.3、Qwen3.8、Ling 3.0 接力出场,累计近四十个模型。各家架构说明里的关键词越来越像,翻来覆去就是 RMSNorm、RoPE、GQA、MoE 这几样。本文把 39 个模型的模块选型汇总到同一张表,并按模块说明技术方案;模型条目链接主要公开来源,相关技术另列论文。2026-09-09 更新:补充 5 月至 8 月发布的 12 个条目(#27–38)。
核对说明:表格优先采用官方技术报告、模型卡和配置文件;来源列同时标明资料类型。官方资料未披露的字段不据此推断。DeepSeek V4-Pro 与 V4-Flash 的逐层注意力配置以官方技术报告为准,具体差异见表格脚注。
配图说明:文中架构图除特别标注外,取自 Sebastian Raschka 的《The Big LLM Architecture Comparison》和各模型论文,版权归原作者。表格数据逐行引用主要公开来源;可取得官方技术报告和配置文件的条目已做交叉核对。
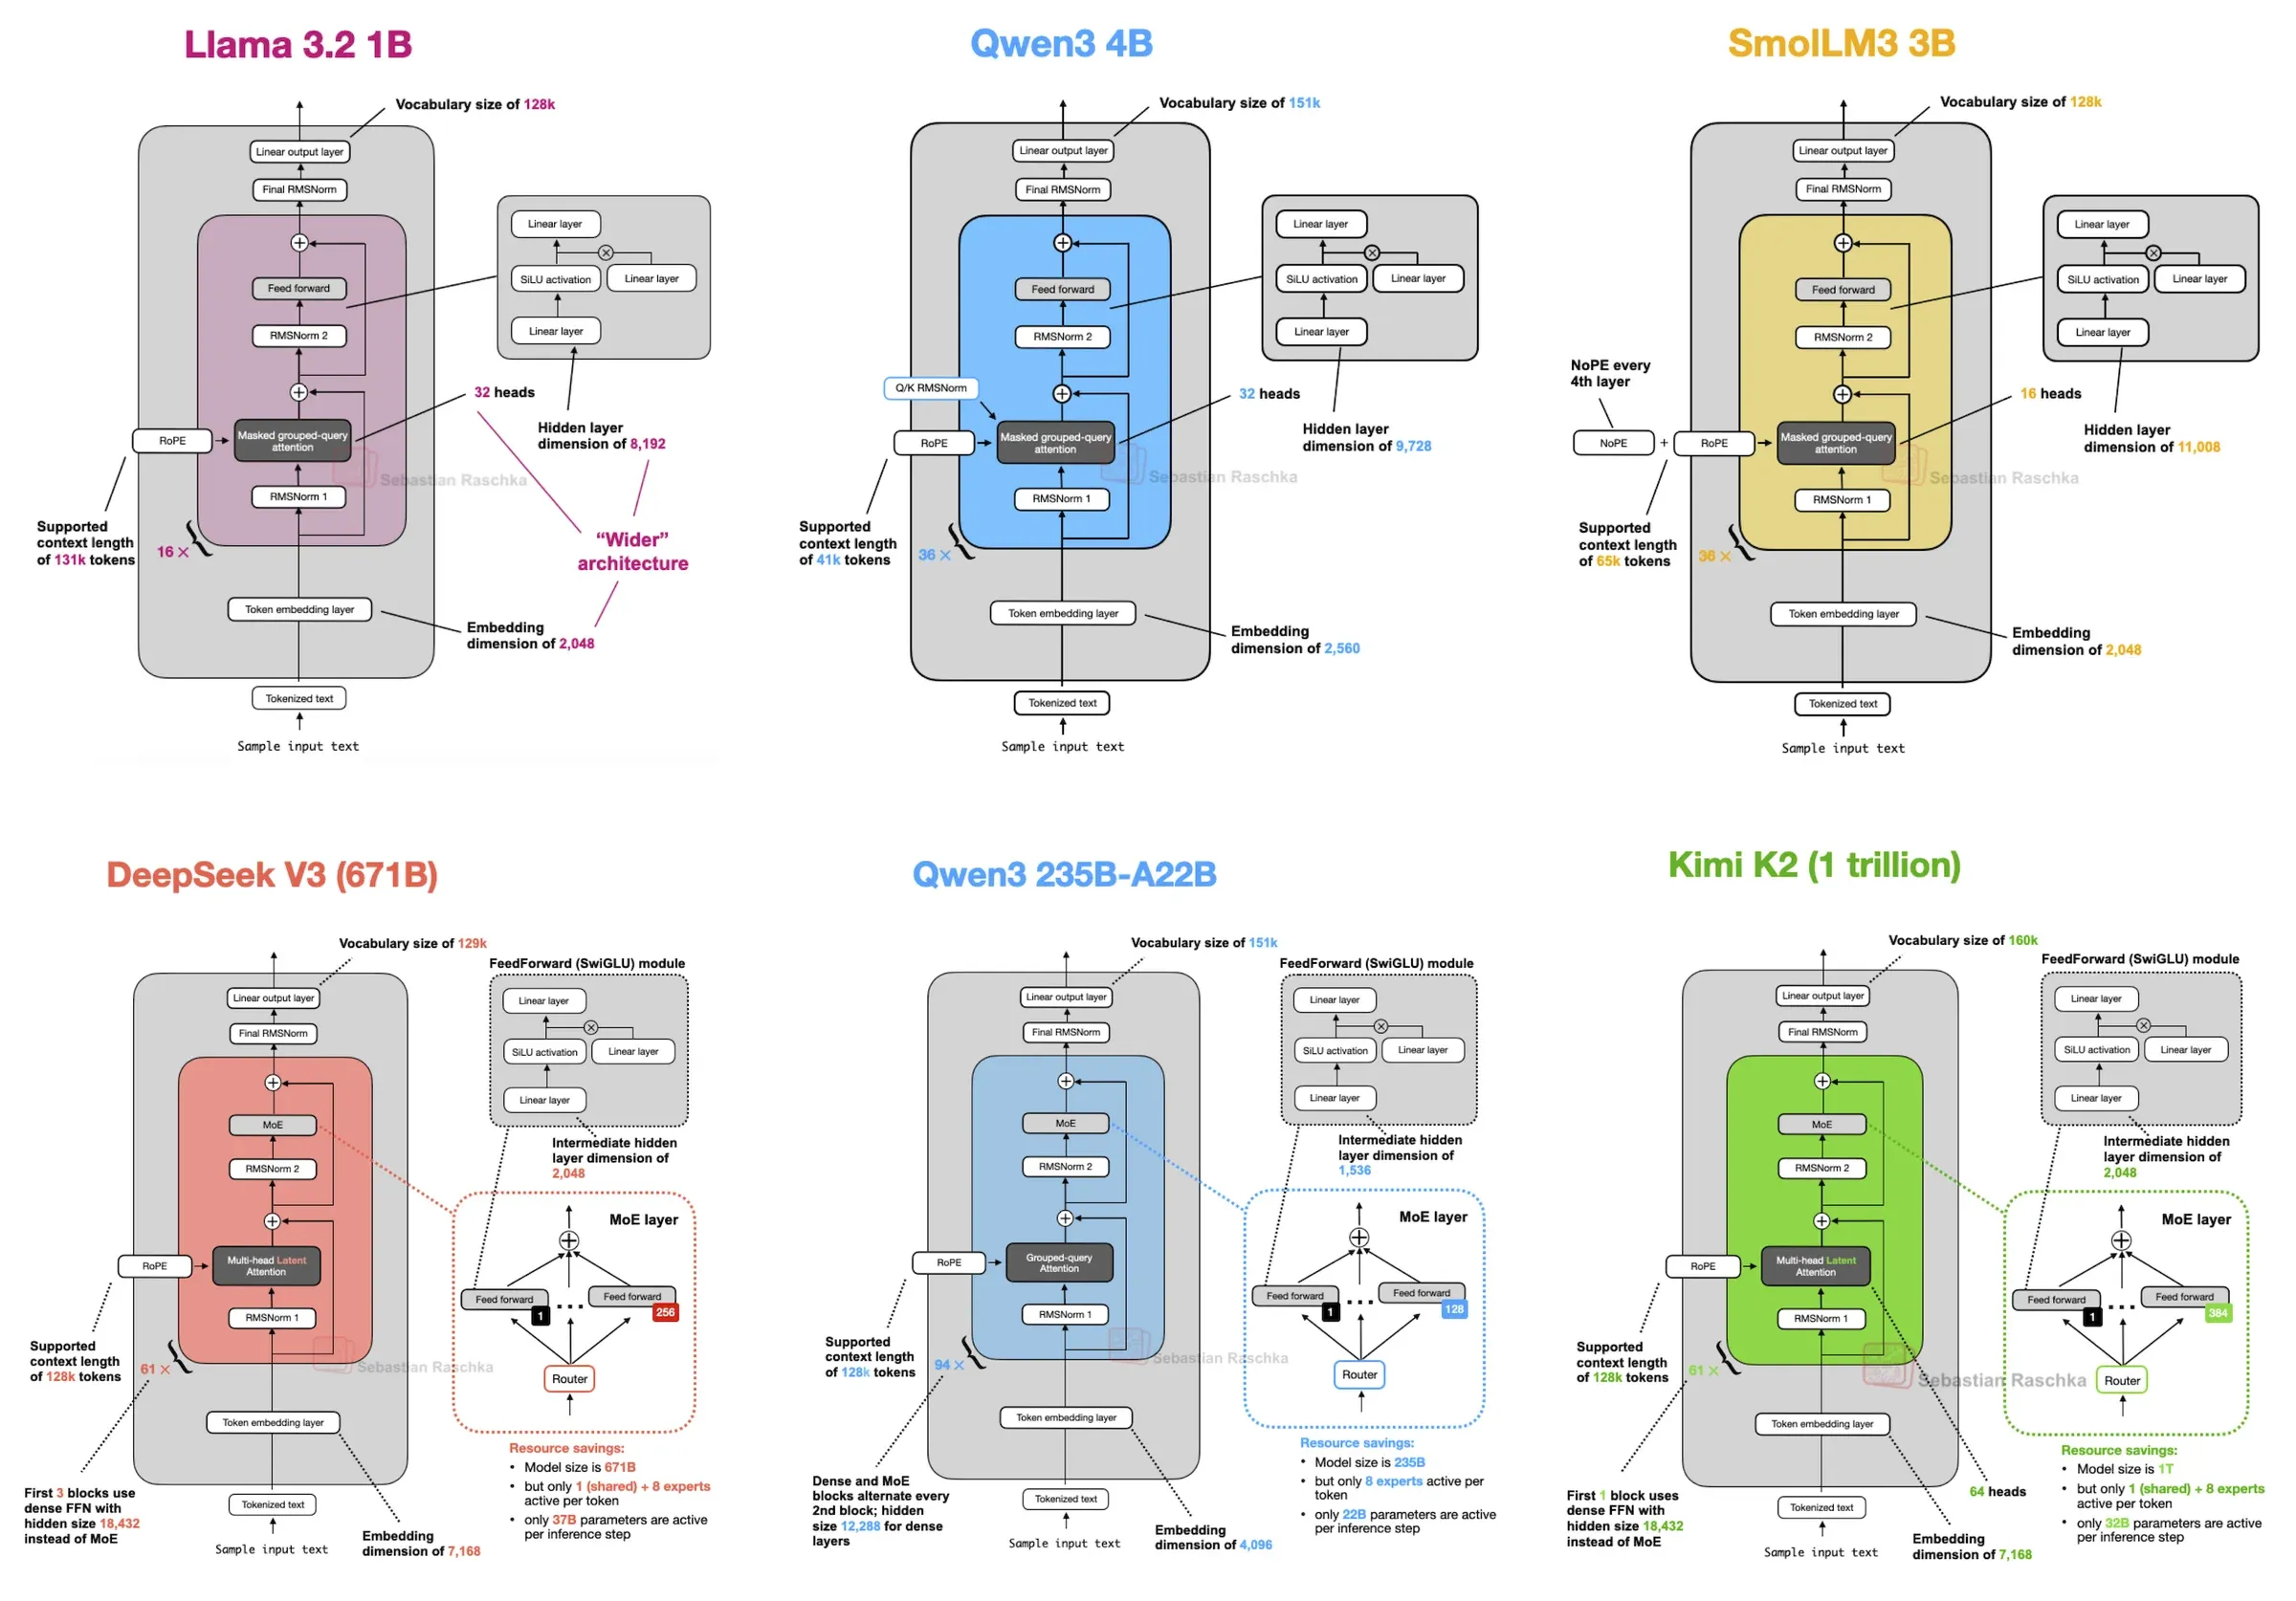
汇总大表
列的含义先交代一下:FFN 列的 Sparse 指 MoE(每个 token 只激活部分专家)、Dense 指稠密前馈;归一化列合并了 Pre-Norm / Post-Norm / Attention 内部的 Norm 三个位置;Attention 列按「主要机制 + 辅助机制」写,比例标在括号里;残差列中 RC 指普通残差连接,mHC 指流形约束超连接。编号从 0 开始、按发布日期排序,只收录 2026 年 1 月之后发布的模型,更早的不在本文统计范围内;#27 起为 2026-09-09 更新补充的 5–8 月条目。
| # | 模型 | 发布日期 | 上下文 | 参数(总/激活) | 归一化 | 位置编码 | Attention | 残差 | FFN | 激活函数 | 主要来源 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | Kimi K2.5 (1T) | 2026/01/27 | 256K | 1T / 32B | RMSNorm (Pre) | RoPE | MLA | RC | Sparse | SiLU | arXiv:2602.02276 |
| 1 | Arcee Trinity Large (400B) | 2026/01/27 | 512K | 400B / 13B | RMSNorm (Pre+Post) + QK-RMSNorm | RoPE+NoPE | GQA + SWA (3:1) | RC | Sparse | SiLU | GitHub 技术报告 |
| 2 | Step 3.5 Flash (196B) | 2026/02/01 | 262K | 196B / 11B | RMSNorm (Pre) | RoPE | GQA + SWA (3:1) | RC | Sparse | SiLU | arXiv:2602.10604 |
| 3 | Nanbeige 4.1 (3B) | 2026/02/10 | 262K | 3B / 3B | RMSNorm (Pre) | RoPE | GQA | RC | Dense | SiLU | arXiv:2602.13367 |
| 4 | GLM-5 (744B) | 2026/02/11 | 203K | 744B / 40B | RMSNorm (Pre) | RoPE | MLA + DSA | RC | Sparse | SiLU | arXiv:2602.15763 |
| 5 | MiniMax-M2.5 (230B) | 2026/02/12 | 197K | 230B / 10B | RMSNorm (Pre) + QK-RMSNorm | RoPE | GQA(全注意力) | RC | Sparse | SiLU | arXiv:2605.26494 |
| 6 | Tiny Aya (3.35B) | 2026/02/13 | 8K | 3.35B / 3.35B | LayerNorm | RoPE+NoPE | GQA + SWA (3:1) | RC | Dense | SiLU | arXiv:2603.11510 |
| 7 | Ling 2.5 (1T) | 2026/02/15 | 256K | 1T / 63B | RMSNorm (Pre) | RoPE | MLA + LightningAttn | RC | Sparse | SiLU | HF 模型卡 |
| 8 | Qwen3.5 (397B) | 2026/02/16 | 262K | 397B / 17B | RMSNorm (Pre) | RoPE | GatedAttn + DeltaNet (3:1) | RC | Sparse | SiLU | HF 配置 |
| 9 | Sarvam (105B) | 2026/03/03 | 131K | 105B / 10.3B | RMSNorm (Pre) + KV-LayerNorm | RoPE+NoPE | MLA | RC | Sparse | SiLU | 官方博客 |
| 10 | Sarvam (30B) | 2026/03/03 | 131K | 30B / 2.4B | RMSNorm (Pre) + QK-RMSNorm | RoPE | GQA | RC | Sparse | SiLU | 官方博客 |
| 11 | Nemotron 3 Super (120B) | 2026/03/11 | 1M | 120B / 12B | RMSNorm (Post) | RoPE | GQA + Mamba-2 | RC | Sparse | SiLU | arXiv:2604.12374 |
| 12 | Mistral Small 4 (119B) | 2026/03/16 | 256K | 119B / 6.63B | RMSNorm (Pre) | RoPE | MLA | RC | Sparse | SiLU | HF 模型卡 |
| 13 | Nemotron 3 Nano (4B) | 2026/03/16 | 262K | 4B / 4B | RMSNorm (Post) | RoPE | GQA + Mamba-2 | RC | Dense | SiLU | HF 博客 |
| 14 | MiniMax M2.7 (230B) | 2026/03/18 | 197K | 230B / 10B | RMSNorm (Pre) + QK-RMSNorm | RoPE | GQA(全注意力) | RC | Sparse | SiLU | 官方公告 |
| 15 | Gemma 4 (31B) | 2026/04/02 | 256K | 30.7B / 30.7B | RMSNorm (Pre+Post) + QK-RMSNorm | RoPE | GQA + SWA (5:1) | RC | Dense | GELU | HF 模型卡 |
| 16 | Gemma 4 (26B-A4B) | 2026/04/02 | 256K | 25.2B / 3.8B | RMSNorm (Pre+Post) + QK-RMSNorm | RoPE | GQA + SWA (5:1) | RC | Sparse | GELU | HF 模型卡 |
| 17 | Gemma 4 (E4B) | 2026/04/02 | 128K | 8B / (4.5B) | RMSNorm (Pre+Post) + QK-RMSNorm | RoPE | GQA + SWA | RC | Dense | GELU | HF 模型卡 |
| 18 | Gemma 4 (E2B) | 2026/04/02 | 128K | 5.1B / (2.3B) | RMSNorm (Pre+Post) + QK-RMSNorm | RoPE | GQA + SWA | RC | Dense | GELU | HF 模型卡 |
| 19 | GLM-5.1 (744B) | 2026/04/07 | 203K | 744B / 40B | RMSNorm (Pre) | RoPE | MLA + DSA | RC | Sparse | SiLU | GLM-5 仓库 |
| 20 | Qwen3.6 (35B-A3B) | 2026/04/15 | 262K | 35B / 3B | RMSNorm (Pre) | RoPE | GatedAttn + DeltaNet (3:1) | RC | Sparse | SiLU | HF 模型卡 |
| 21 | Kimi K2.6 (1T) | 2026/04/20 | 256K | 1T / 32B | RMSNorm (Pre) | RoPE | MLA | RC | Sparse | SiLU | HF 模型卡 |
| 22 | Xiaomi MiMo-V2.5 (310B) | 2026/04/22 | 1M | 310B / 15B | RMSNorm (Pre) | RoPE | GQA + SWA (5:1) | RC | Sparse | SiLU | HF 模型卡 |
| 23 | Qwen3.6 (27B) | 2026/04/22 | 262K | 27B / 27B | RMSNorm (Pre) | RoPE | GatedAttn + DeltaNet (3:1) | RC | Dense | SiLU | 官方博客 |
| 24 | Ling 2.6 (1T) | 2026/04/23 | 262K | 1T / 63B | RMSNorm (Pre) | RoPE | MLA + LightningAttn (7:1) | RC | Sparse | SiLU | HF 模型卡 |
| 25 | DeepSeek V4-Pro (1.6T) | 2026/04/24 | 1M | 1.6T / 49B* | RMSNorm (Pre) + Q/KV-RMSNorm | p-RoPE+YaRN | CSA + HCA + SWA* | mHC | Sparse | SiLU | arXiv:2606.19348 |
| 26 | DeepSeek V4-Flash (284B) | 2026/04/24 | 1M | 284B / 13B | RMSNorm (Pre) + Q/KV-RMSNorm | p-RoPE+YaRN | CSA + HCA + SWA* | mHC | Sparse | SiLU | arXiv:2606.19348 |
| 27 | Step 3.7 Flash (198B) | 2026/05/23 | 262K | 198B / 11B | RMSNorm (Pre) | p-RoPE | GQA + SWA (3:1) | RC | Sparse | SiLU | HF 模型卡 |
| 28 | Gemma 4 (12B) | 2026/05/23 | 256K | 12B / 12B | RMSNorm (Pre+Post) + QK-RMSNorm | p-RoPE(全局层) | GQA + SWA (5:1) | RC | Dense | GELU | HF 模型卡 |
| 29 | MiniMax-M3 (428B) | 2026/06/02 | 1M | 428B / 23B | RMSNorm (Pre+Post) + QK-RMSNorm | p-RoPE | GQA + MSA | RC | Sparse | SiLU | HF 模型卡 |
| 30 | Kimi K3 (2.8T) | 2026/06/13 | 1M | 2.8T / 104B | RMSNorm (Pre) | RoPE+NoPE | KDA + Gated MLA (69:24) | AttnRes | Sparse | SiTU** | HF 模型卡 |
| 31 | GLM-5.2 (744B) | 2026/06/16 | 1M | 744B / 40B | RMSNorm (Pre) | RoPE | MLA + DSA (IndexShare) | RC | Sparse | SiLU | z.ai 博客 |
| 32 | Nemotron 3.5 Lightning (30B-A3B) | 2026/08/01 | 256K | 31.6B / 3B | RMSNorm (Pre) | RoPE | GQA + Mamba-2 | RC | Sparse | ReLU² | HF 模型卡 |
| 33 | Ling 3.0-flash (124B) | 2026/08/02 | 256K | 124B / 5.1B | RMSNorm (Pre) + QK-RMSNorm | RoPE | KDA + MLA (5:1) | RC | Sparse | SiLU | HF 模型卡 |
| 34 | Qwen3.8 (27B) | 2026/08/05 | 262K | 27B / 27B | RMSNorm (Pre) | p-RoPE | GatedAttn + DeltaNet (3:1) | RC | Dense | SiLU | HF 模型卡 |
| 35 | Qwen3.8 (2.4T) | 2026/08/08 | 262K | 2.4T / 95B | RMSNorm (Pre) | p-RoPE | GatedAttn + DeltaNet (3:1) | RC | Sparse | SiLU | HF 模型卡 |
| 36 | Ling 3.0-tiny (7.9B) | 2026/08/10 | 128K | 7.9B / 1.3B | RMSNorm (Pre) + QK-RMSNorm | RoPE | KDA + MLA (3:1) | RC | Sparse | SiLU | HF 模型卡 |
| 37 | Qwen3.8-Flash-Next (125B) | 2026/08/24 | 262K | 125B+51B / 6B | RMSNorm (Pre) | p-RoPE | GatedDeltaNet + QSA (3:1) | Gated Res | Sparse | SiLU | 官方博客 |
| 38 | GLM-5.3-Flash (320B) | 2026/08/25 | 1M | 320B / 18B | RMSNorm (Pre) | NoPE+RoPE** | Linear Attn + DSA (3:1) | mHC | Sparse | SiLU | z.ai 博客 |
* 官方技术报告显示:V4-Pro 的激活参数为 49B,前 2 层使用 HCA,其余层交替使用 CSA 与 HCA;V4-Flash 的前 2 层使用纯 SWA,其余层交替使用 CSA 与 HCA。两种注意力都含 SWA 支路。
** Kimi K3 配置文件中的激活函数标注为 situ,官方资料未展开说明,表中照录。GLM-5.3-Flash 的主注意力与线性注意力层均未配置 RoPE 维度,仅 DSA 索引器使用 RoPE,是表中唯一一例。7 月底至 8 月的 DeepSeek V4-Flash-0731(304B)与 V4-Pro-0813(1.65T)为同架构刷新版(CSA/HCA + mHC 不变,路由专家数微调),不单独列行。
从本表的 39 个样本可直接读出:9 个是 Dense(Nanbeige、Tiny Aya、Nemotron 3 Nano 4B、Gemma 4 四档、Qwen3.6 27B、Qwen3.8 27B),其余 30 个采用 MoE;位置编码均属于 RoPE 系或 RoPE+NoPE 混合,其中 p-RoPE(部分维度旋转)在下半年的新条目里明显变多,未收录采用绝对位置编码的模型;Gemma 4 的五个条目使用 GELU,Nemotron 3.5 Lightning 使用 ReLU²,其余条目的激活函数标为 SiLU;34 个模型使用 RC,DeepSeek V4 两个模型与 GLM-5.3-Flash 使用 mHC,Kimi K3 与 Qwen3.8-Flash-Next 分别尝试了 AttnRes 与 Gated Residual 两种新残差。样本间最明显的差异集中在 Attention 和归一化两列。
下面按模块拆开讲。
归一化:放哪比用什么更要紧
表格里归一化这一列其实叠了三个问题:Norm 用什么(RMSNorm 几乎垄断,只有 Tiny Aya 还在用 LayerNorm)、放在哪(Pre 还是 Post)、以及注意力内部要不要额外加 Norm(QK-Norm)。
Pre-Norm 与 Post-Norm
2017 年的原版 Transformer 用的是 Post-LN:归一化放在注意力和前馈层之后。GPT-2 及后续许多 LLM 采用 Pre-LN。Xiong et al. 2020 讨论了 Pre-LN 在初始化时更稳定的梯度行为;这有助于深层网络训练,但不应视为训练稳定性的唯一原因。Pre-LN 的表达能力与优化特性仍需结合具体模型和训练设置判断。
2025 年 OLMo 2 重新采用了 Post-Norm 变体:把 RMSNorm 放在注意力/FFN 之后,但保留在残差分支内部——不是回到原版 Post-LN,而是「残差内的 Post-Norm」。实验显示,该组合的训练损失更稳定。OLMo 2 技术报告:arXiv:2501.00656。
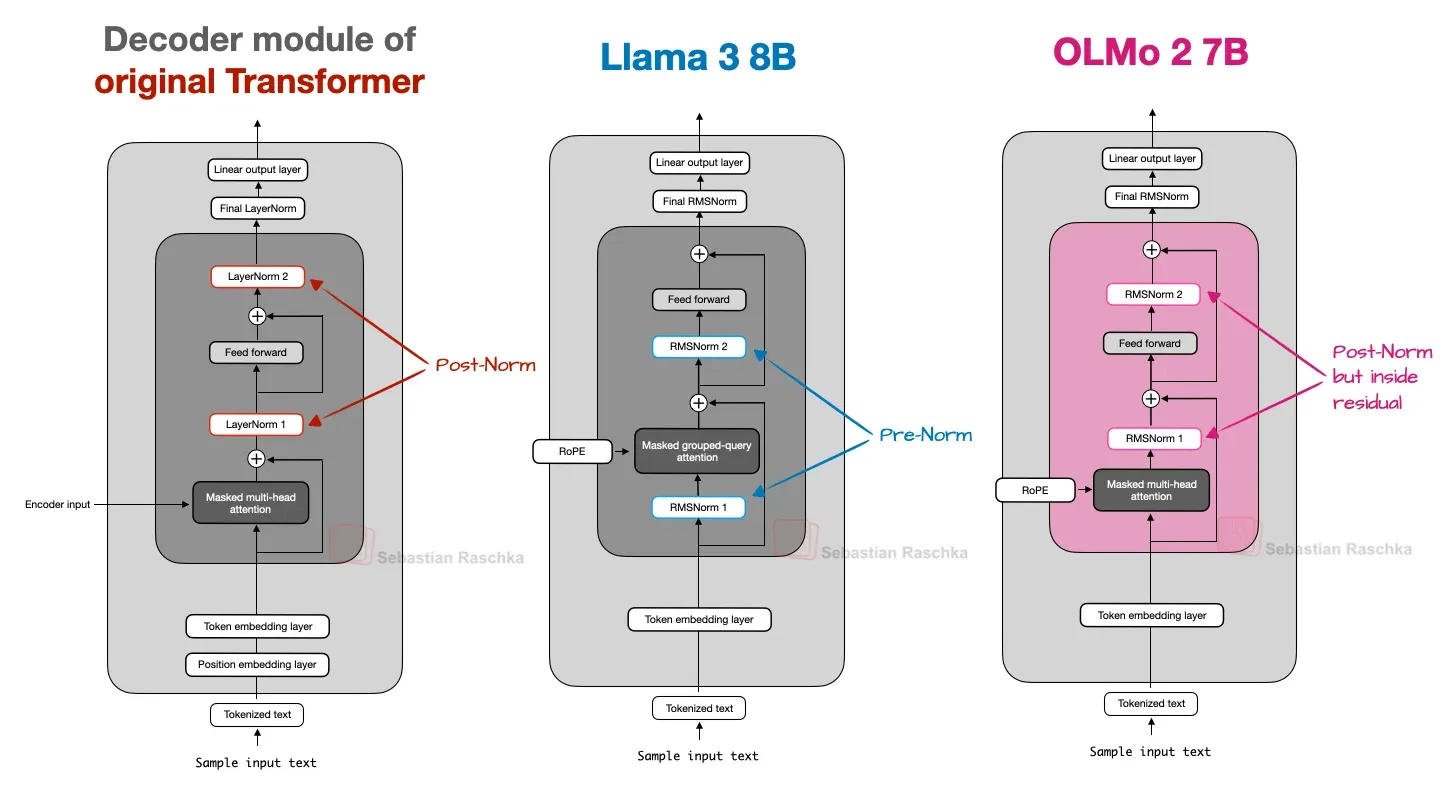
在本表样本中,Nemotron 3 系列采用 Post-Norm,Gemma 4、Trinity 和 MiniMax-M3(M3 起)采用「两端均归一化」的 Sandwich 路线,其余条目多为标准 Pre-Norm。三种做法并存,说明归一化位置仍需随模型和训练配置评估。
Sandwich Norm:两头都包
Gemma 系列从 Gemma 2 开始就在注意力模块前后各放一个 RMSNorm。相较于注意力和 FFN,RMSNorm 的计算开销通常较小,因此可以采用这一额外归一化结构。
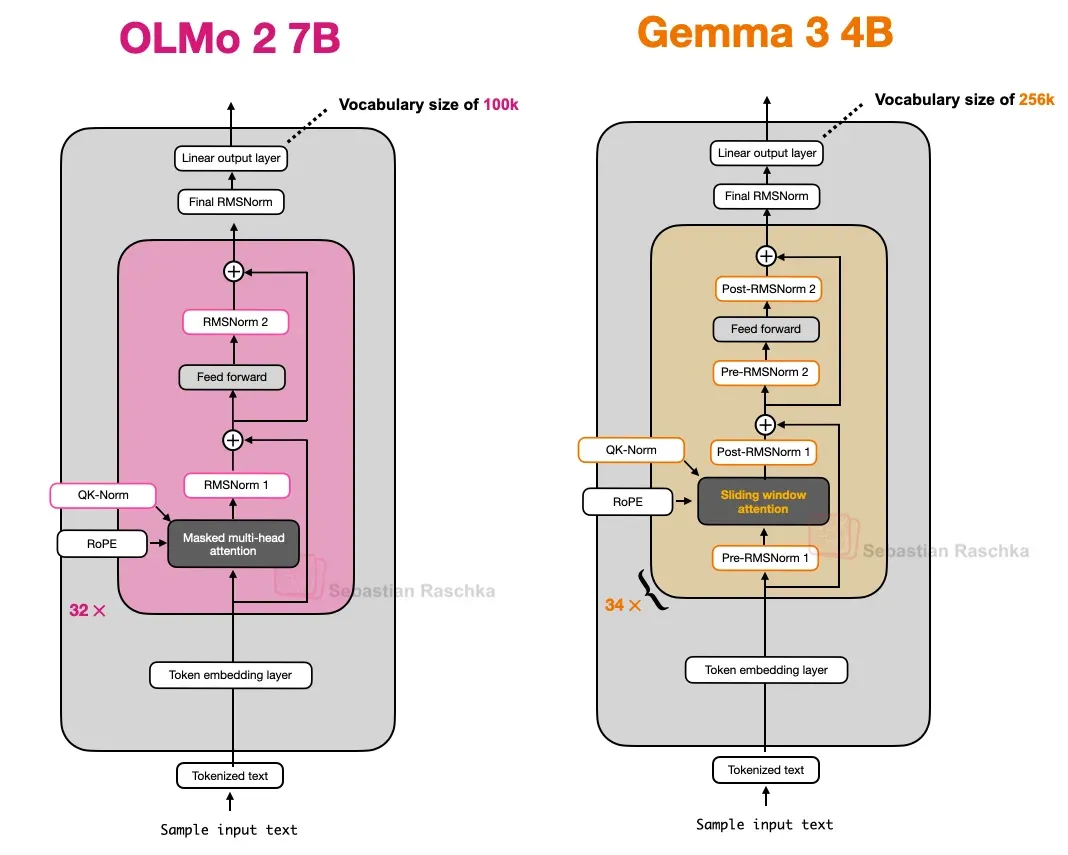
Trinity Large 在此基础上加入 depth-scaled sandwich norm:后置 RMSNorm 的增益按 1/√L 初始化(L 是总层数)。训练早期残差更新较小,随后随训练推进放大。其技术报告称,这一初始化有助于缓解 attention sink 并稳定长序列训练。
QK-Norm:压住注意力的 logits
QK-Norm 就是在 Q 和 K 进 RoPE 之前各加一个 RMSNorm,防止注意力 logits 爆掉。思路来自 2023 年的 Scaling Vision Transformers,OLMo 2、Gemma 2/3/4、Sarvam 30B 都在用。
MiniMax M2 系列做了一个变体:per-layer QK-Norm。普通 QK-Norm 的缩放参数跨注意力头共享,MiniMax 给每个头独立的 RMSNorm 参数;M3 延续 per-head QK-Norm,并同时引入后置 RMSNorm,从 Pre-Norm 转向 Sandwich。代码可见 vLLM 的实现。
KV-LayerNorm:Sarvam 的私有配方
Sarvam 105B 在 KV 侧加了 LayerNorm 配合 MLA 使用,这是表格里唯一一例。官方没给太细的消融,Raschka 的架构画廊把它标注为 “MLA with KV LayerNorm and NoPE + RoPE”。属于小众但值得记录的设计。
位置编码:RoPE 一统天下,然后开始做减法
RoPE(旋转位置编码)已经是绝对主流,2026 年的看点是谁在 RoPE 上做减法。
Partial RoPE(p-RoPE):只给一部分维度做旋转。MiniMax 系列只旋转一半的 head 维度,官方报告称这有助于长度外推(MiniMax-01 技术报告);Gemma 4 只给 25% 的频率对加入位置信息,以减少长上下文中的位置噪声。下半年这个做法明显扩散:Qwen3.8 全系(含 Flash-Next)在注意力层采用 25% 部分旋转,Step 3.7 Flash 和 MiniMax-M3 旋转一半维度,Gemma 4 12B 的全局层同样只旋转 25%。
NoPE(无位置编码):2023 年的论文表明,在其研究设置中,因果掩码本身可提供位置信号;省略显式位置编码时,长度外推可能更好。
RoPE+NoPE 混合是本表中的一种做法:滑动窗口层用 RoPE,全局注意力层用 NoPE。Trinity Large、Tiny Aya 都采用这一组合。Kimi Linear 的 MLA 全局层也是 NoPE;论文称,这使 MLA 在推理时可按 MQA 运行,并减少长上下文的 RoPE 重调需求。位置编码可以按层配置,而不必全模型统一采用同一种方案。
注意力:真正的战场
这一列信息量最大。把 39 个模型的 Attention 列归拢一下,大概是四条路线。
路线一:GQA + 滑动窗口,性价比组合
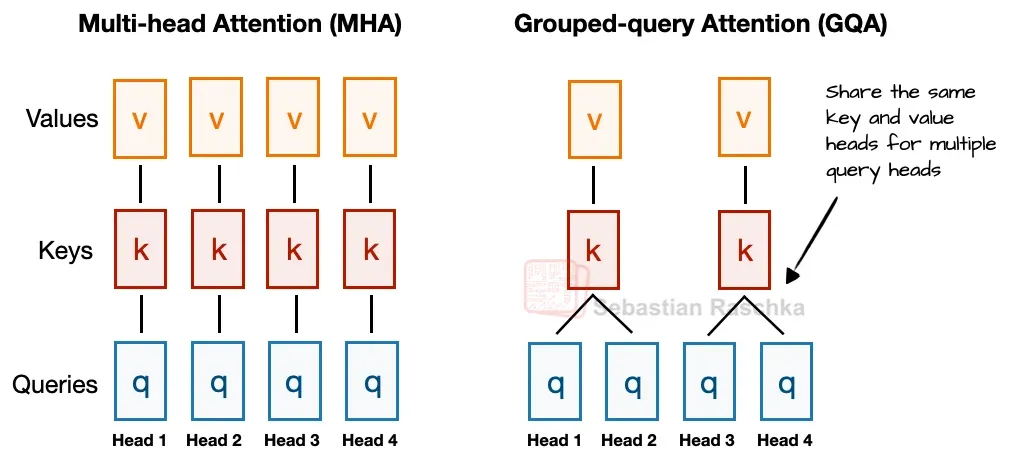
GQA(分组查询注意力,arXiv:2305.13245)让多个 Query 头共享一组 KV 头,从而减少 KV cache。原论文与后续模型的消融通常显示,它可在特定设置中保持接近 MHA 的效果;具体差异取决于头数、分组方式和训练配置。
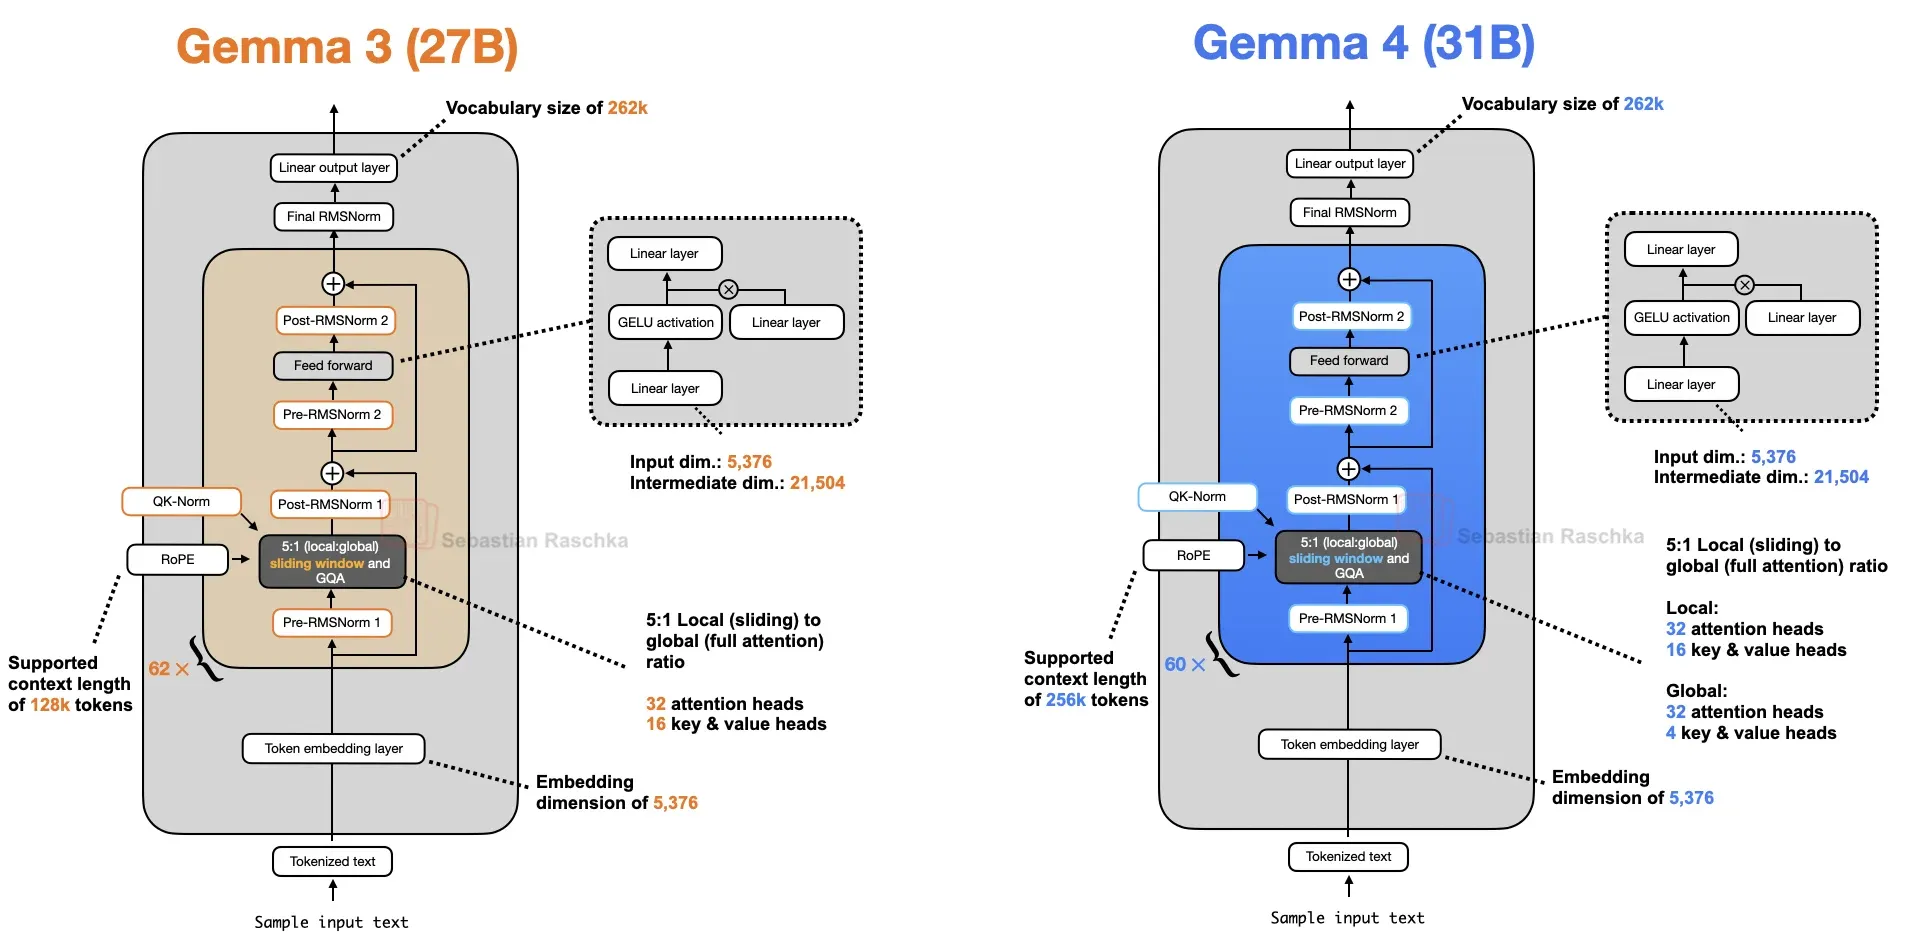
滑动窗口注意力(SWA)让每个 token 只看附近固定窗口。纯 SWA 层的 KV cache 可限制在窗口范围内;混合架构若仍保留全局层,整体 KV cache 仍会随序列长度增长,但增长速率更低。思想来自 Longformer,Gemma 3 采用 5 层 SWA 配 1 层全局注意力、窗口为 1024 的组合。Gemma 4 延续 5:1 比例,并在全局层复用 key 作为 value(v=k)以进一步减少 KV cache。
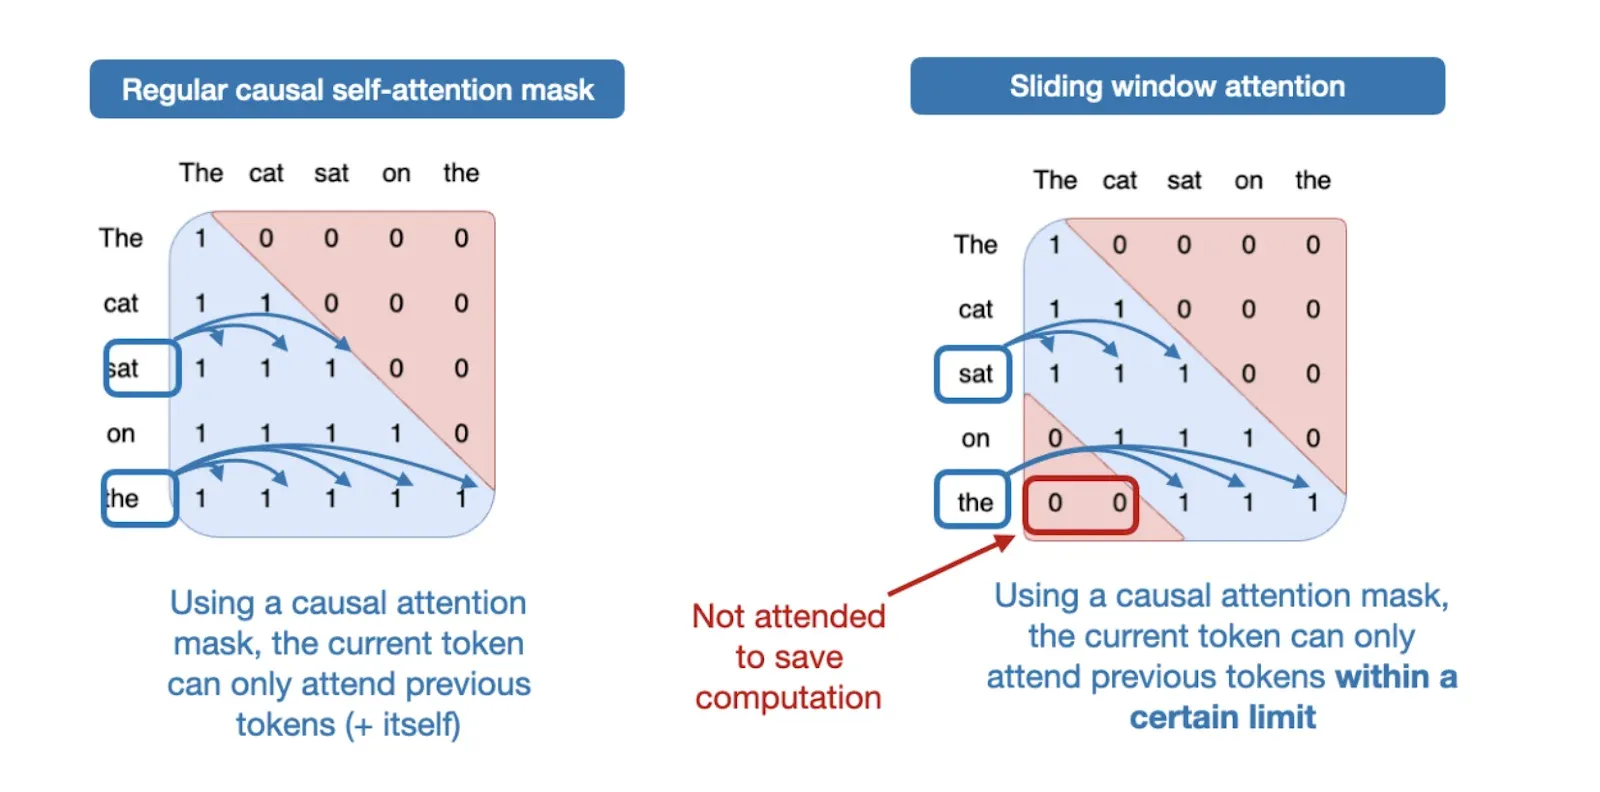
本表中采用这条路线的模型包括:Gemma 4(5:1,窗口 1024)、Step 3.5 Flash(3:1,窗口 512)、Trinity(3:1,窗口 4096)、Tiny Aya(3:1)和 MiMo-V2.5(5:1,窗口 128)。5 月的 Step 3.7 Flash 延续 3:1 与窗口 512,新增了 50% 部分旋转;Gemma 4 家族 5 月补齐的 12B 档与 31B 同配置。Step 3.5 Flash 的论文说明,其选择 SWA 而非线性注意力,是因为 SWA 与 MTP 投机解码兼容,且窗口固定后增加 Query 头(64→96)不会增加长上下文开销。
路线二:MLA,DeepSeek 系的压缩哲学
MLA(多头潜在注意力)由 DeepSeek-V2 引入(arXiv:2405.04434):它将 KV 压缩为低维 latent 向量存入 cache,使用时再投影。GQA 通过减少 KV 副本降低缓存量,MLA 则存储压缩后的 KV。DeepSeek-V2 的消融实验中,MLA 的效果略优于 MHA;这一结果适用于该论文的实验设置。
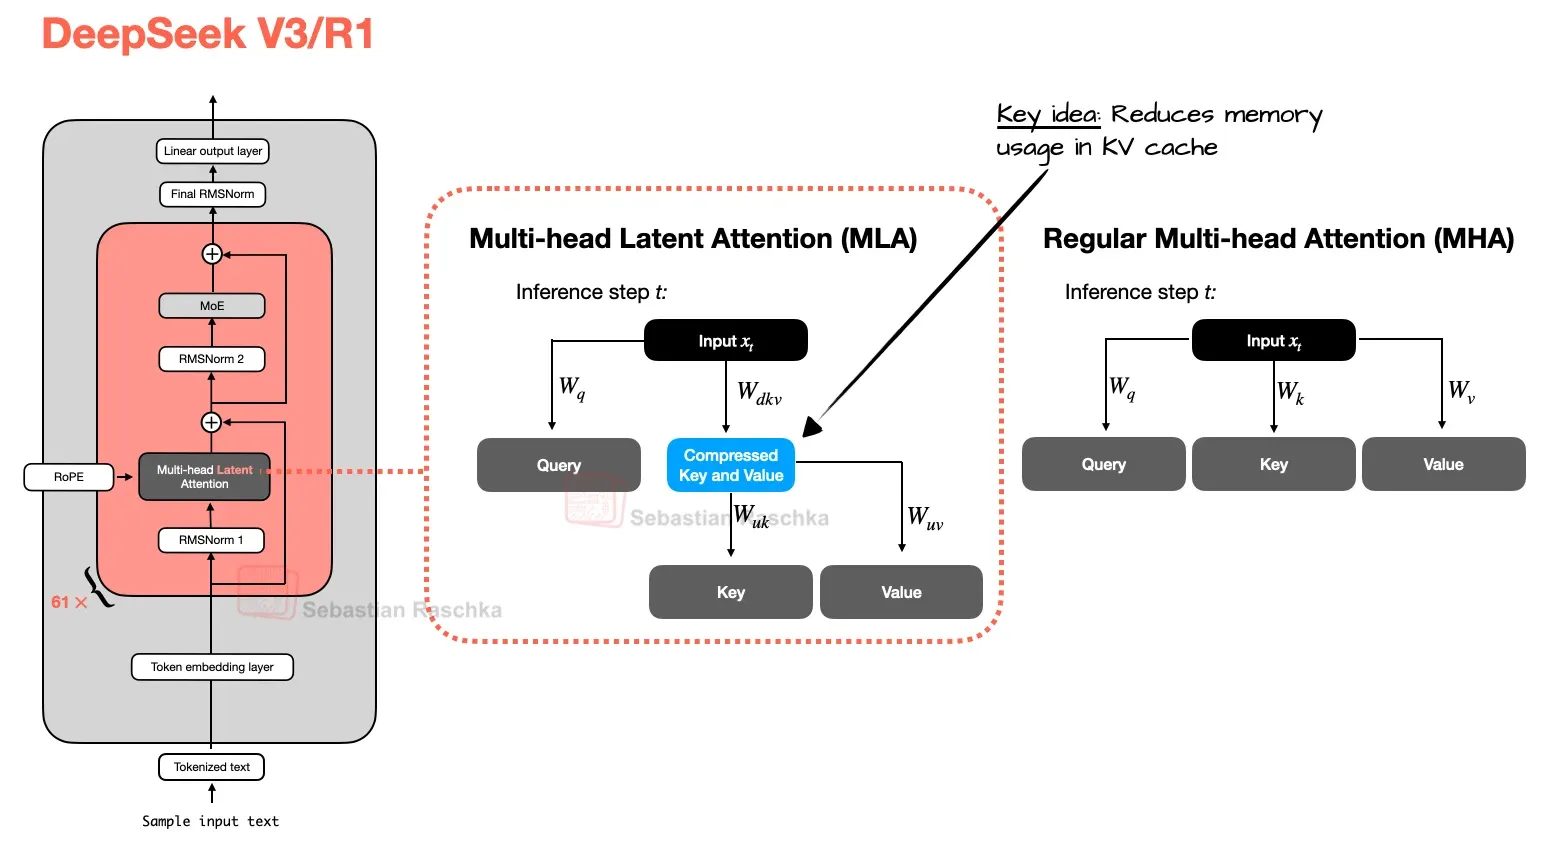
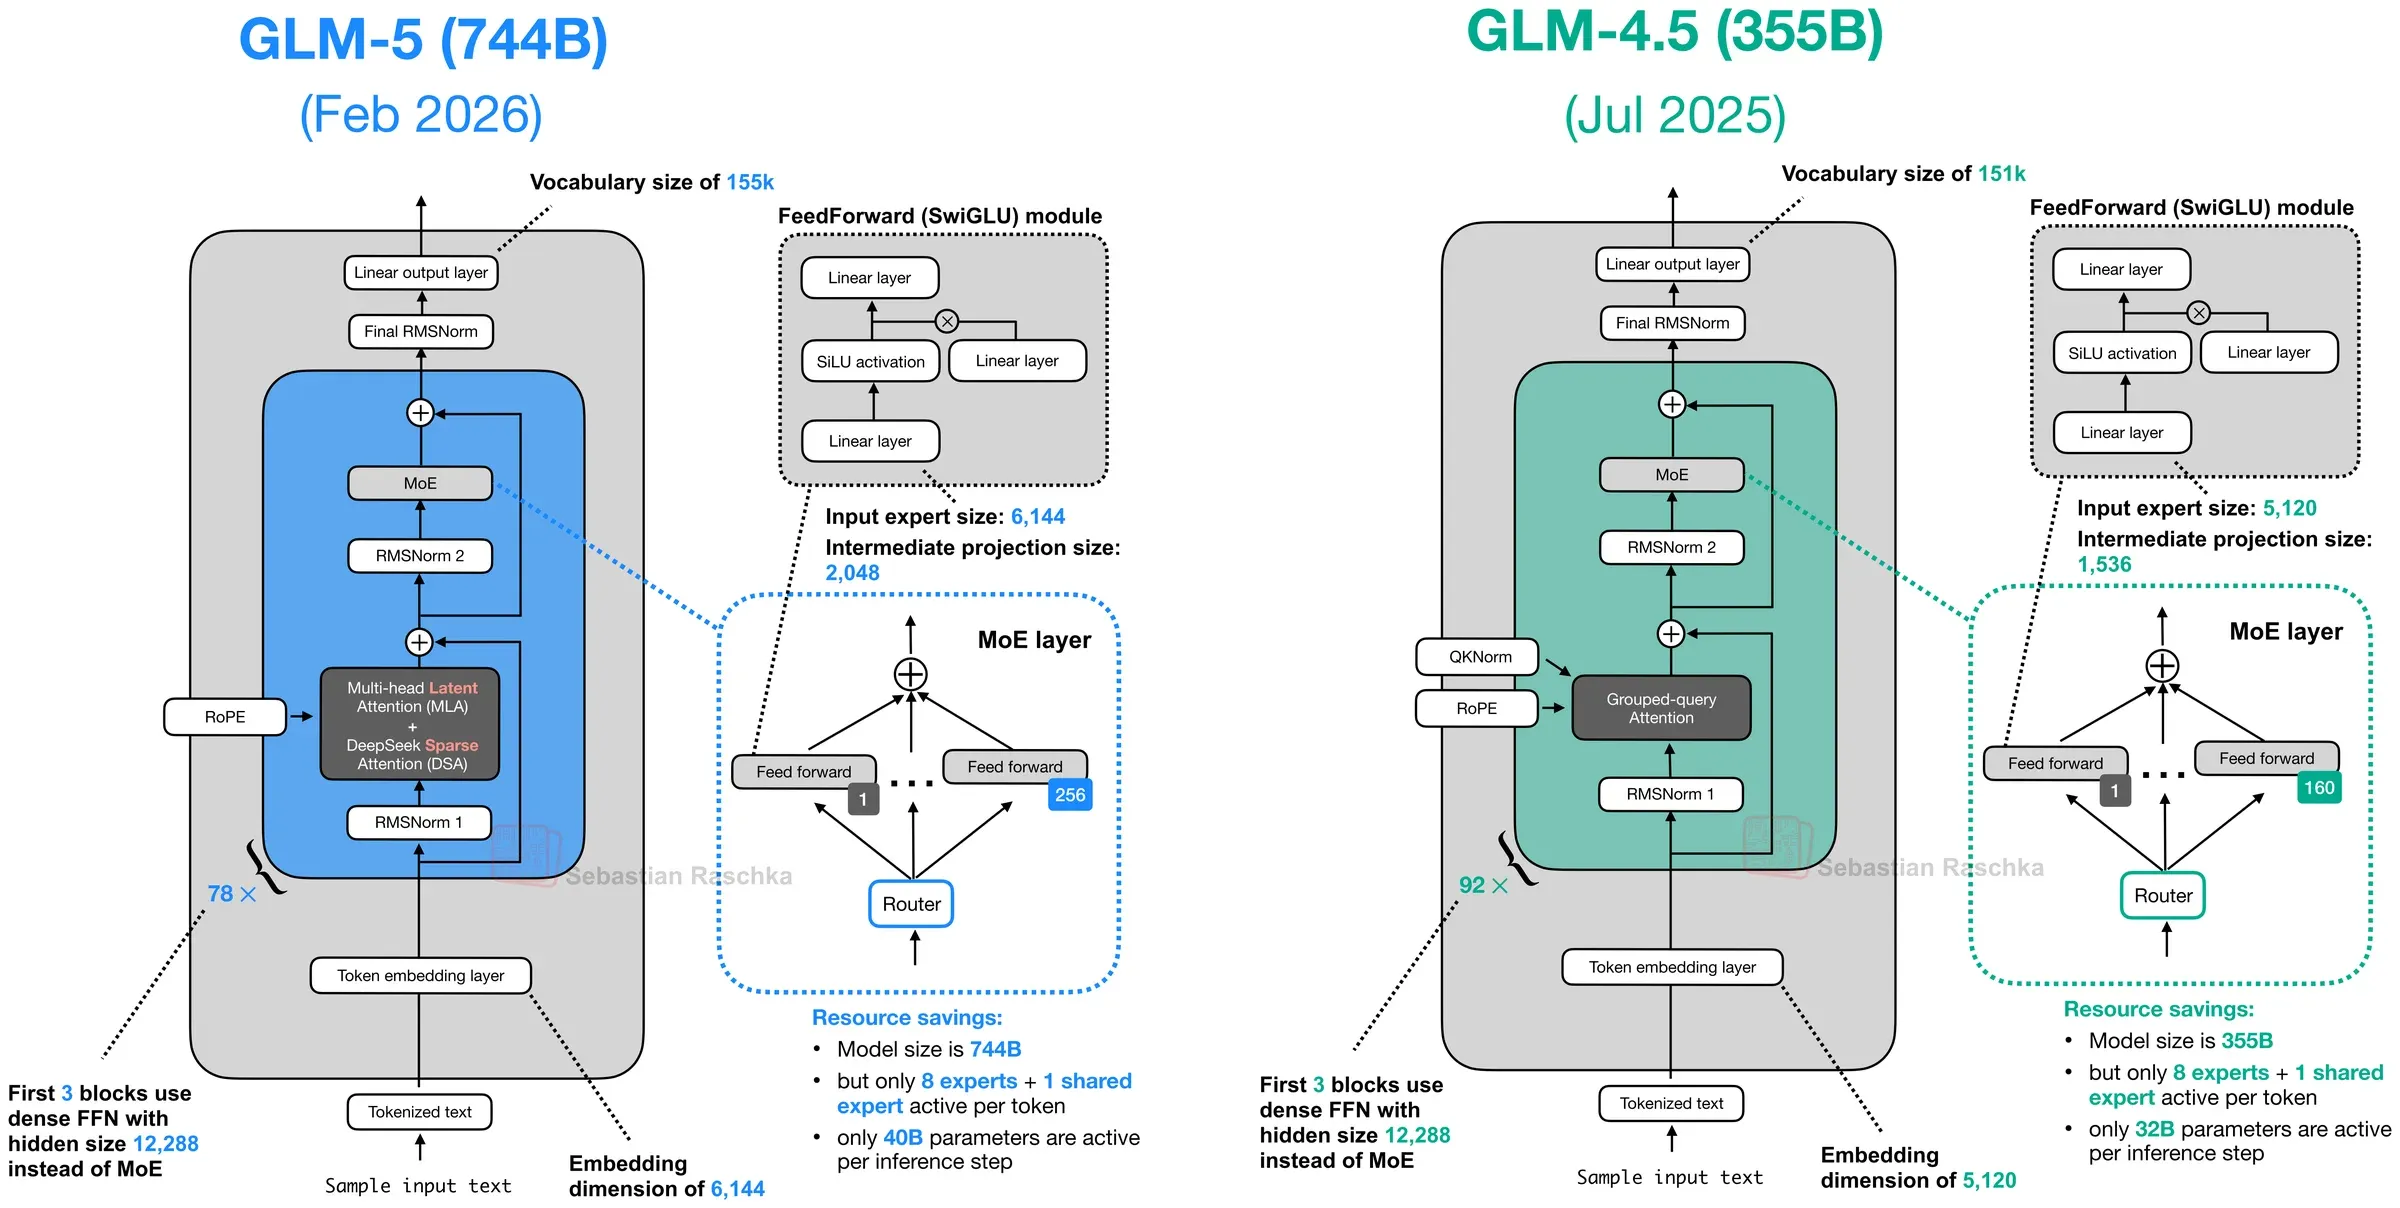
2026 年,MLA 已被 Kimi K2.5/K2.6、GLM-5/5.1、Ling 2.5/2.6、Mistral Small 4 和 Sarvam 105B 等模型采用。GLM-5 的技术报告显示,在 Muon 优化器下,576 维 latent 的 MLA 表现不如 GQA-8;将 head dim 从 192 提到 256、头数减少 1/3 后(作者称为 MLA-256)才追平。MLA 的效果需要与训练配方和超参数一并评估。6 月的 GLM-5.2 保留同一套 MLA+DSA 骨架,把上下文扩到稳定的 1M,并提出 IndexShare:稀疏索引器每 4 层复用一个,降低索引开销。另值得注意的是,纯 MLA 作为旗舰主架构在 K3 上画上句号——Kimi 的下一代转向了 KDA 混合(见路线四)。
路线三:稀疏注意力,服务超长上下文
GQA/MLA 省的是 KV cache 显存,但注意力的计算量还是 O(n²)。要做百万级上下文,得让每个 token 别看全部历史。
DSA(DeepSeek Sparse Attention):V3.2 引入(arXiv:2512.02556)。一个轻量的 lightning indexer 给每个 token 打分,选出少量相关 token 做精细注意力,其余粗略处理。V3.2 之后,GLM-5 直接在继续预训练阶段接入 DSA(他们的消融显示长上下文基准上 DSA 版优于 MLA-only 版),Kimi 的 K2.5 沿用 MLA 不动(到 K3 才改换门庭,见路线四)。
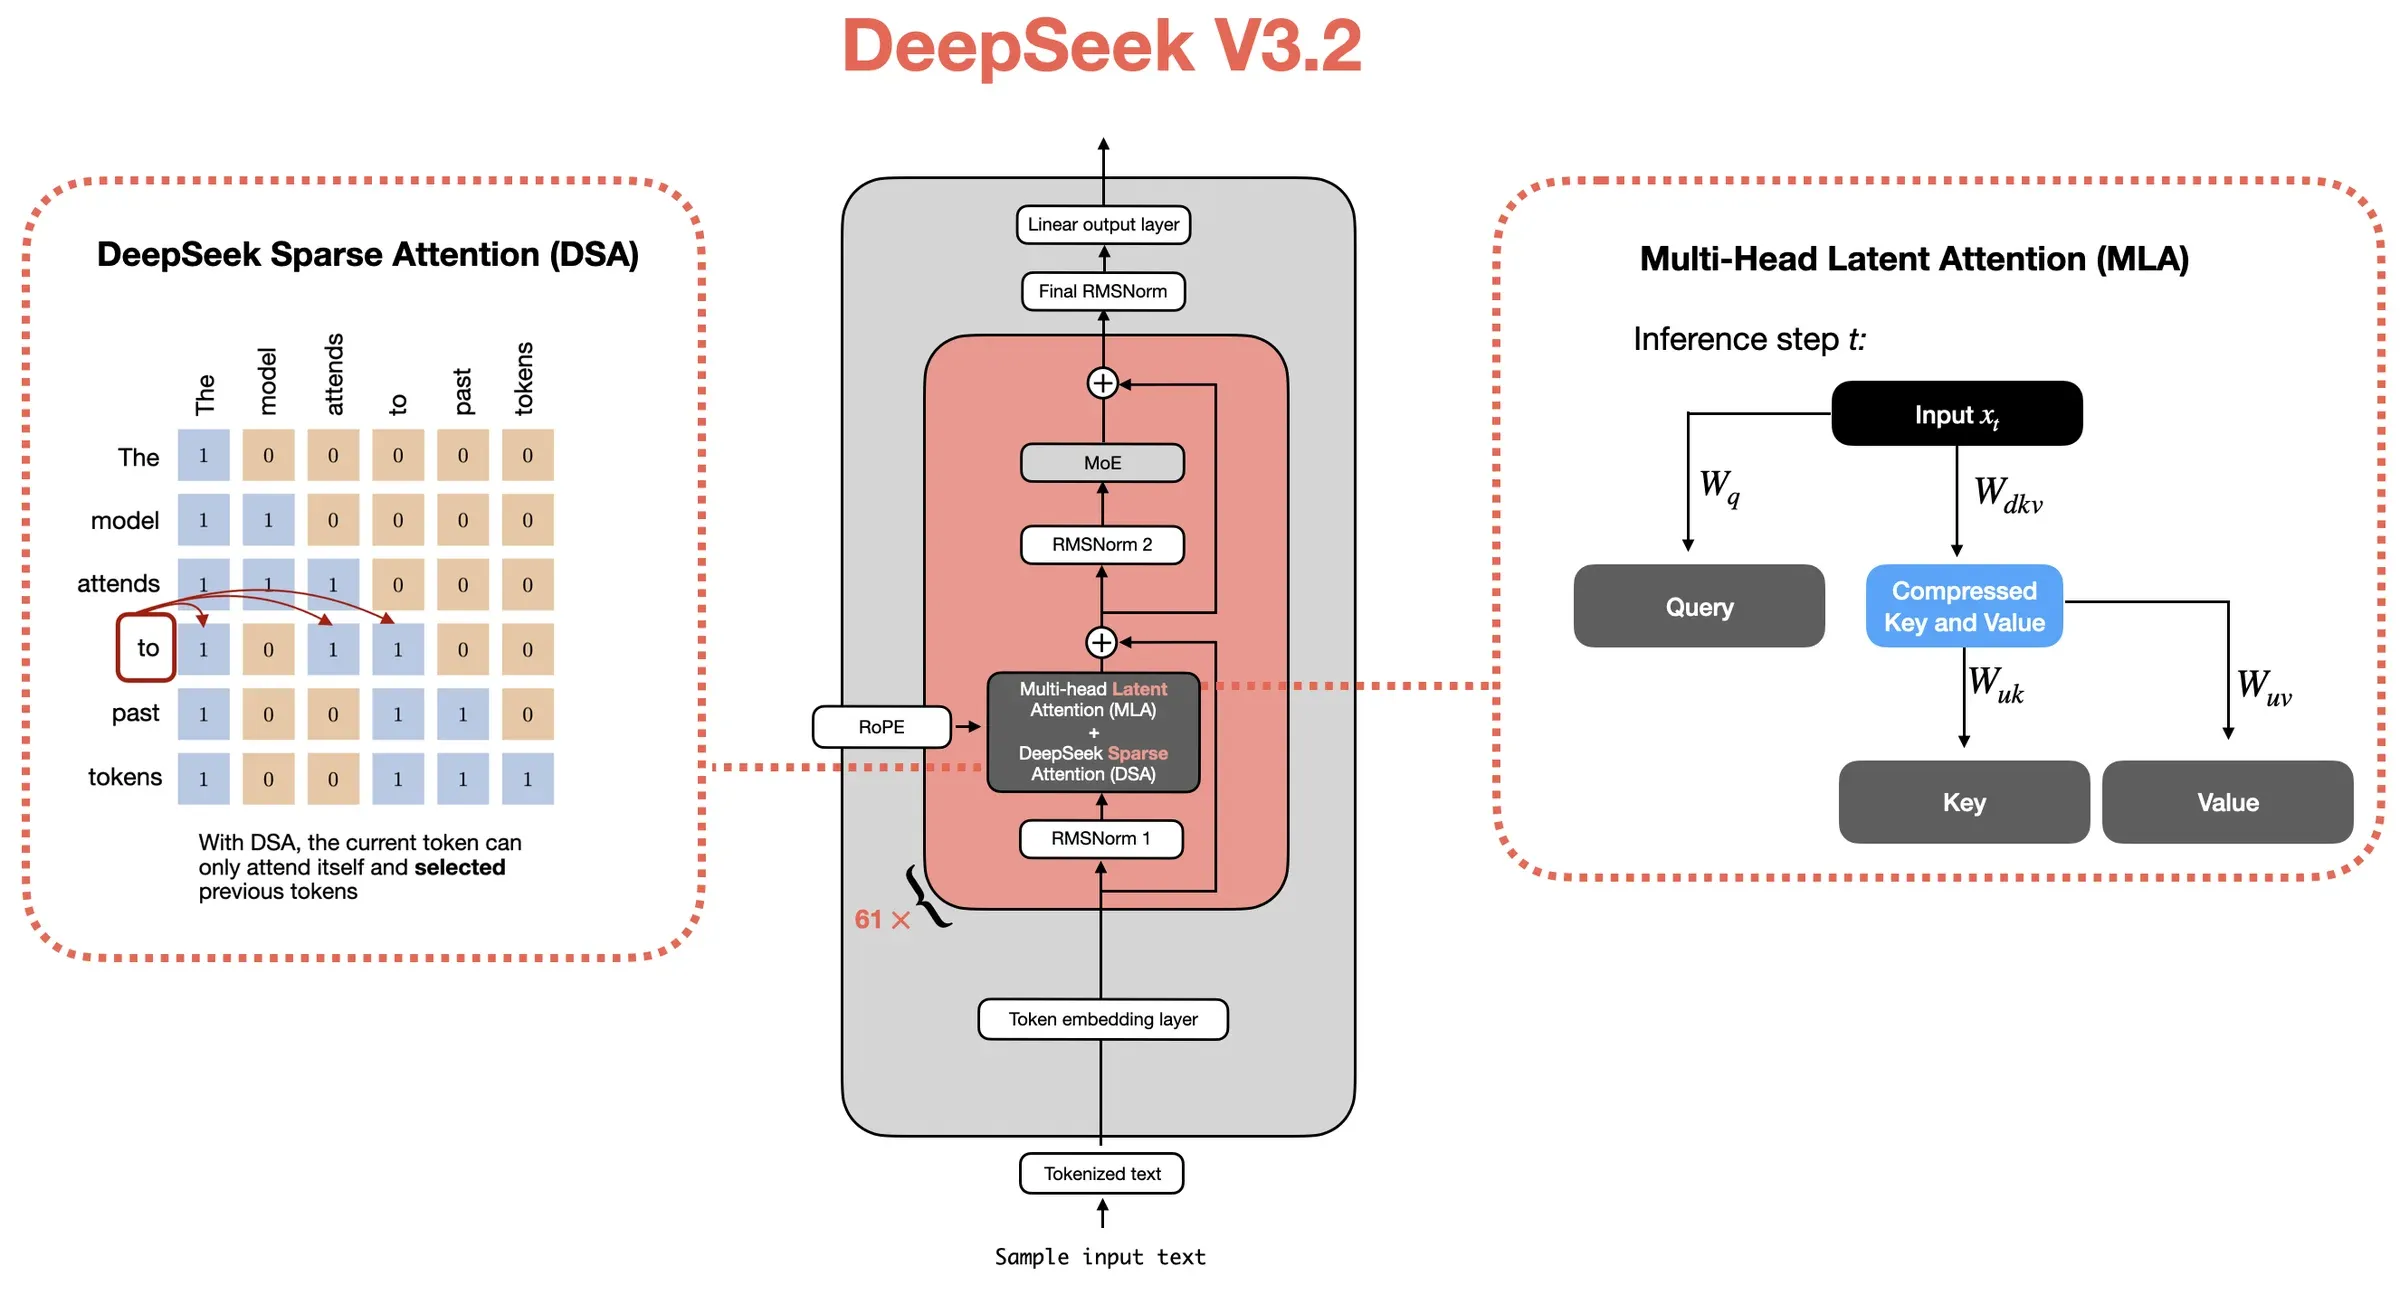
CSA/HCA:DeepSeek V4(arXiv:2606.19348)将稀疏化进一步用于长上下文。CSA(压缩稀疏注意力)和 HCA(重度压缩注意力)在模型层间交替。官方数据中,在 1M token 场景下,V4-Pro 的单 token 推理 FLOPs 为 V3.2 的 27%,KV cache 为 10%;V4-Flash 分别为 10% 和 7%。这体现了将历史信息压缩为 KV 条目的设计方向。
这条路线在下半年继续扩容。MiniMax-M3 带着自研的 MSA(MiniMax Sparse Attention)回归稀疏阵营:一个 4 头 MQA 索引器按块选出相关 token,M2 的全注意力路线就此作废,官方称 1M 上下文下 prefill 快 9 倍、decode 快 15 倍。GLM-5.3-Flash 则把 DSA 与线性注意力拼进同一个模型(见路线四)。DeepSeek 自家也在 7–8 月放出 V4-Flash-0731 与 V4-Pro-0813 两个刷新版,架构延续 CSA/HCA + mHC。
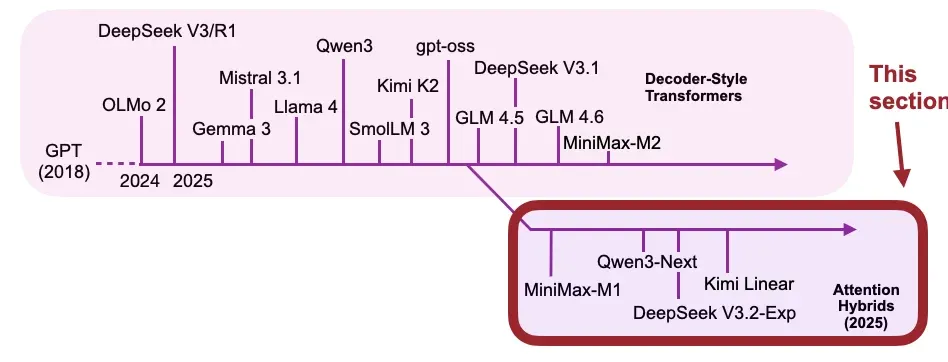
路线四:线性注意力回归,混合架构当道
线性注意力具有 O(n) 复杂度。早期方案受准确性和工程实现限制,应用相对有限;2025 年下半年,混合注意力架构重新受到关注。Raschka 的时间线如下:
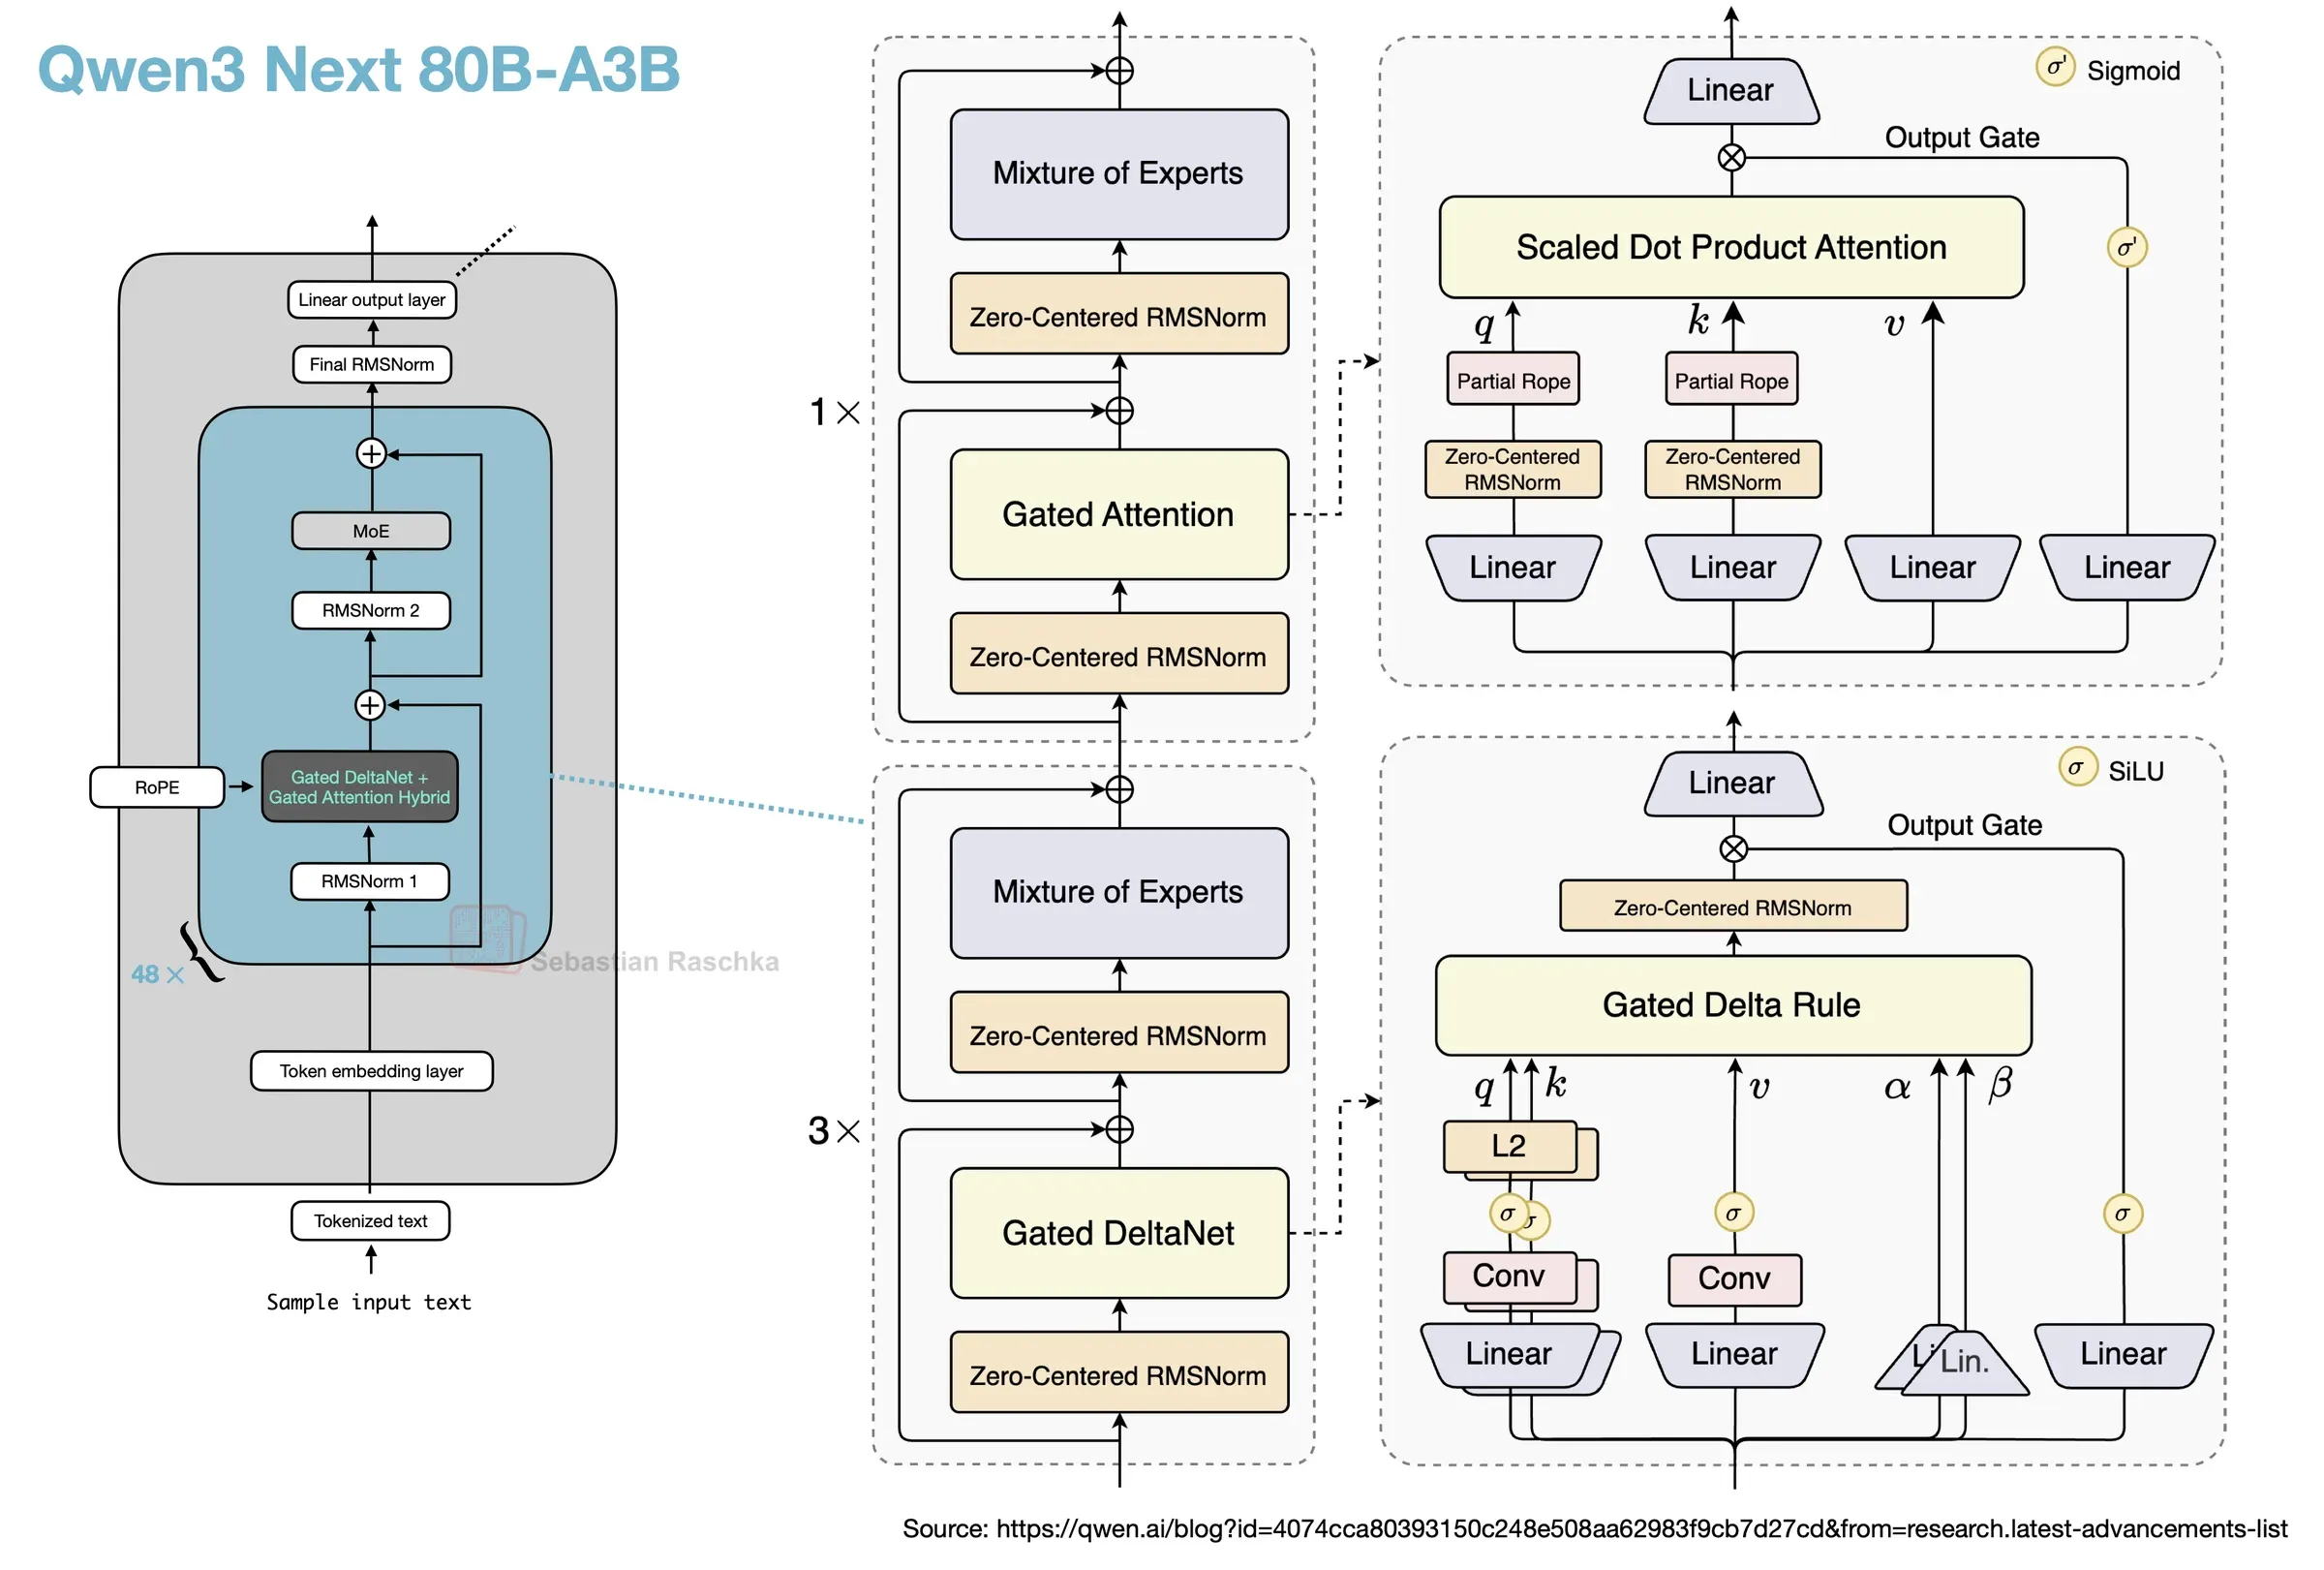
Gated DeltaNet:Qwen3.5/3.6 的选择。DeltaNet 用 delta rule 增量更新一个固定大小的记忆矩阵(可以理解为可学习的快速权重 RNN),Gated 版本加上 Mamba 式的门控衰减(arXiv:2412.06464)。纯线性注意力检索精度不够,所以 Qwen 用 3:1 的比例穿插全注意力层——3 层 Gated DeltaNet 配 1 层 Gated Attention。8 月的 Qwen3.8(27B Dense 与 2.4T-A95B)延续同一配方,另给注意力层加上 25% 的 p-RoPE;实验性的 Qwen3.8-Flash-Next 则把混合中的全注意力层换成块级稀疏的 QSA(Qwen Sparse Attention,不再逐 token 选择而是按 micro-block 选择),官方明确这将是 Qwen4 的架构底座,此外还引入 n-gram 词嵌入与门控残差。
Lightning Attention:MiniMax-01 引入(arXiv:2501.08313),Ant Group 的 Ling 系列随后采用。Ling 2.6 以 7:1 的比例混合 MLA 与 Lightning Attention;其模型卡给出了从 GQA 架构迁移的流程。8 月的 Ling 3.0 则换到 KDA:flash 为 5:1 的 KDA/MLA 混合(124B/5.1B),tiny 以 3:1 做到 7.9B/1.3B、主打端侧部署。MiniMax 自己的 M3 没有延续 Lightning Attention,而是转向了 MSA 稀疏注意力(见路线三)。
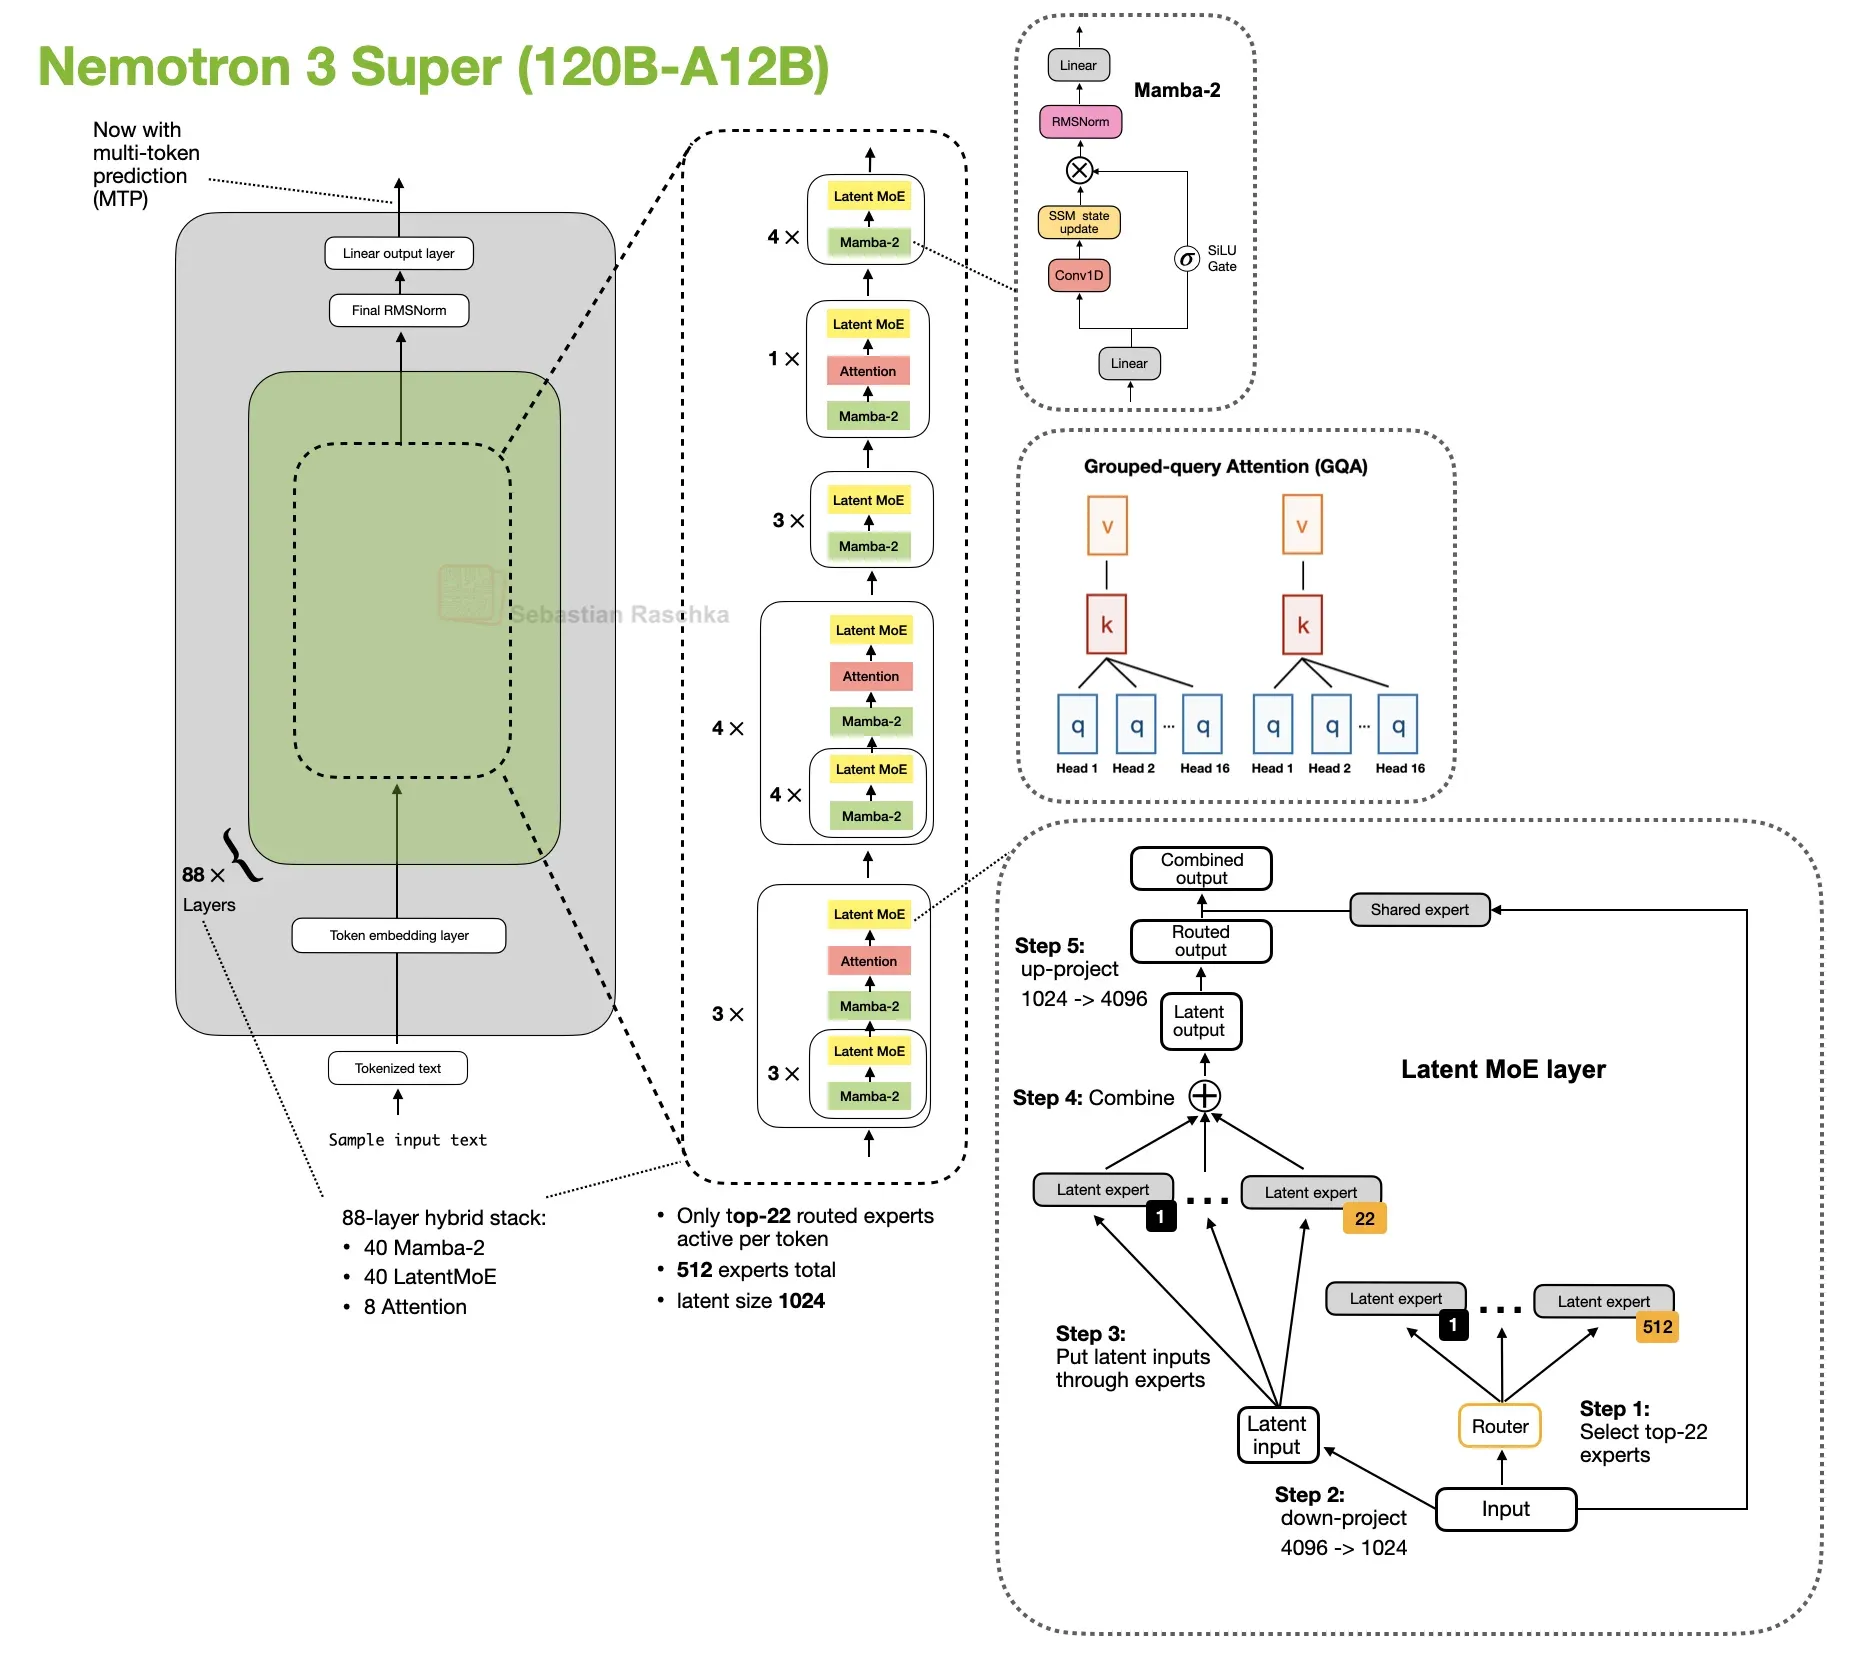
Mamba-2:NVIDIA Nemotron 3 的选择(arXiv:2405.21060)。该系列大多数层采用 Mamba-2,以固定大小状态处理序列;少量注意力层负责全局信息交互。Nano 4B 面向端侧部署,Super 120B 支持 1M 上下文。8 月的 Nemotron 3.5 Lightning(30B-A3B)延续 nemotron_h 混合并改用 MoE(128 选 6),激活函数换成 ReLU²。
Kimi Linear 是这条路线的集大成者:KDA(Kimi Delta Attention,把 Gated DeltaNet 的标量门控细化到每个通道)配 gated MLA,3:1 混合。论文:arXiv:2510.26692。表格里没有 Kimi Linear(它发布于 2025 年 10 月,不在本文统计范围内),但理解 Qwen3.5 的 DeltaNet 时值得对照着看。它的「正主」在 6 月到了:Kimi K3(2.8T/104B)直接以 69 层 KDA + 24 层 Gated MLA(约 3:1)构建,配 896 选 16 的 LatentMoE 和新的 Attention Residuals,1M 上下文——「Kimi 沿用纯 MLA」的判断只维持了半年。另一家把 KDA 用起来的是 Ant 的 Ling 3.0(见上)。GLM-5.3-Flash(320B/18B)则是第一家把线性注意力与 DSA 拼进同一模型:3 层线性注意力配 1 层 DSA,残差换 mHC,主注意力层不再配置 RoPE(仅索引器保留)。
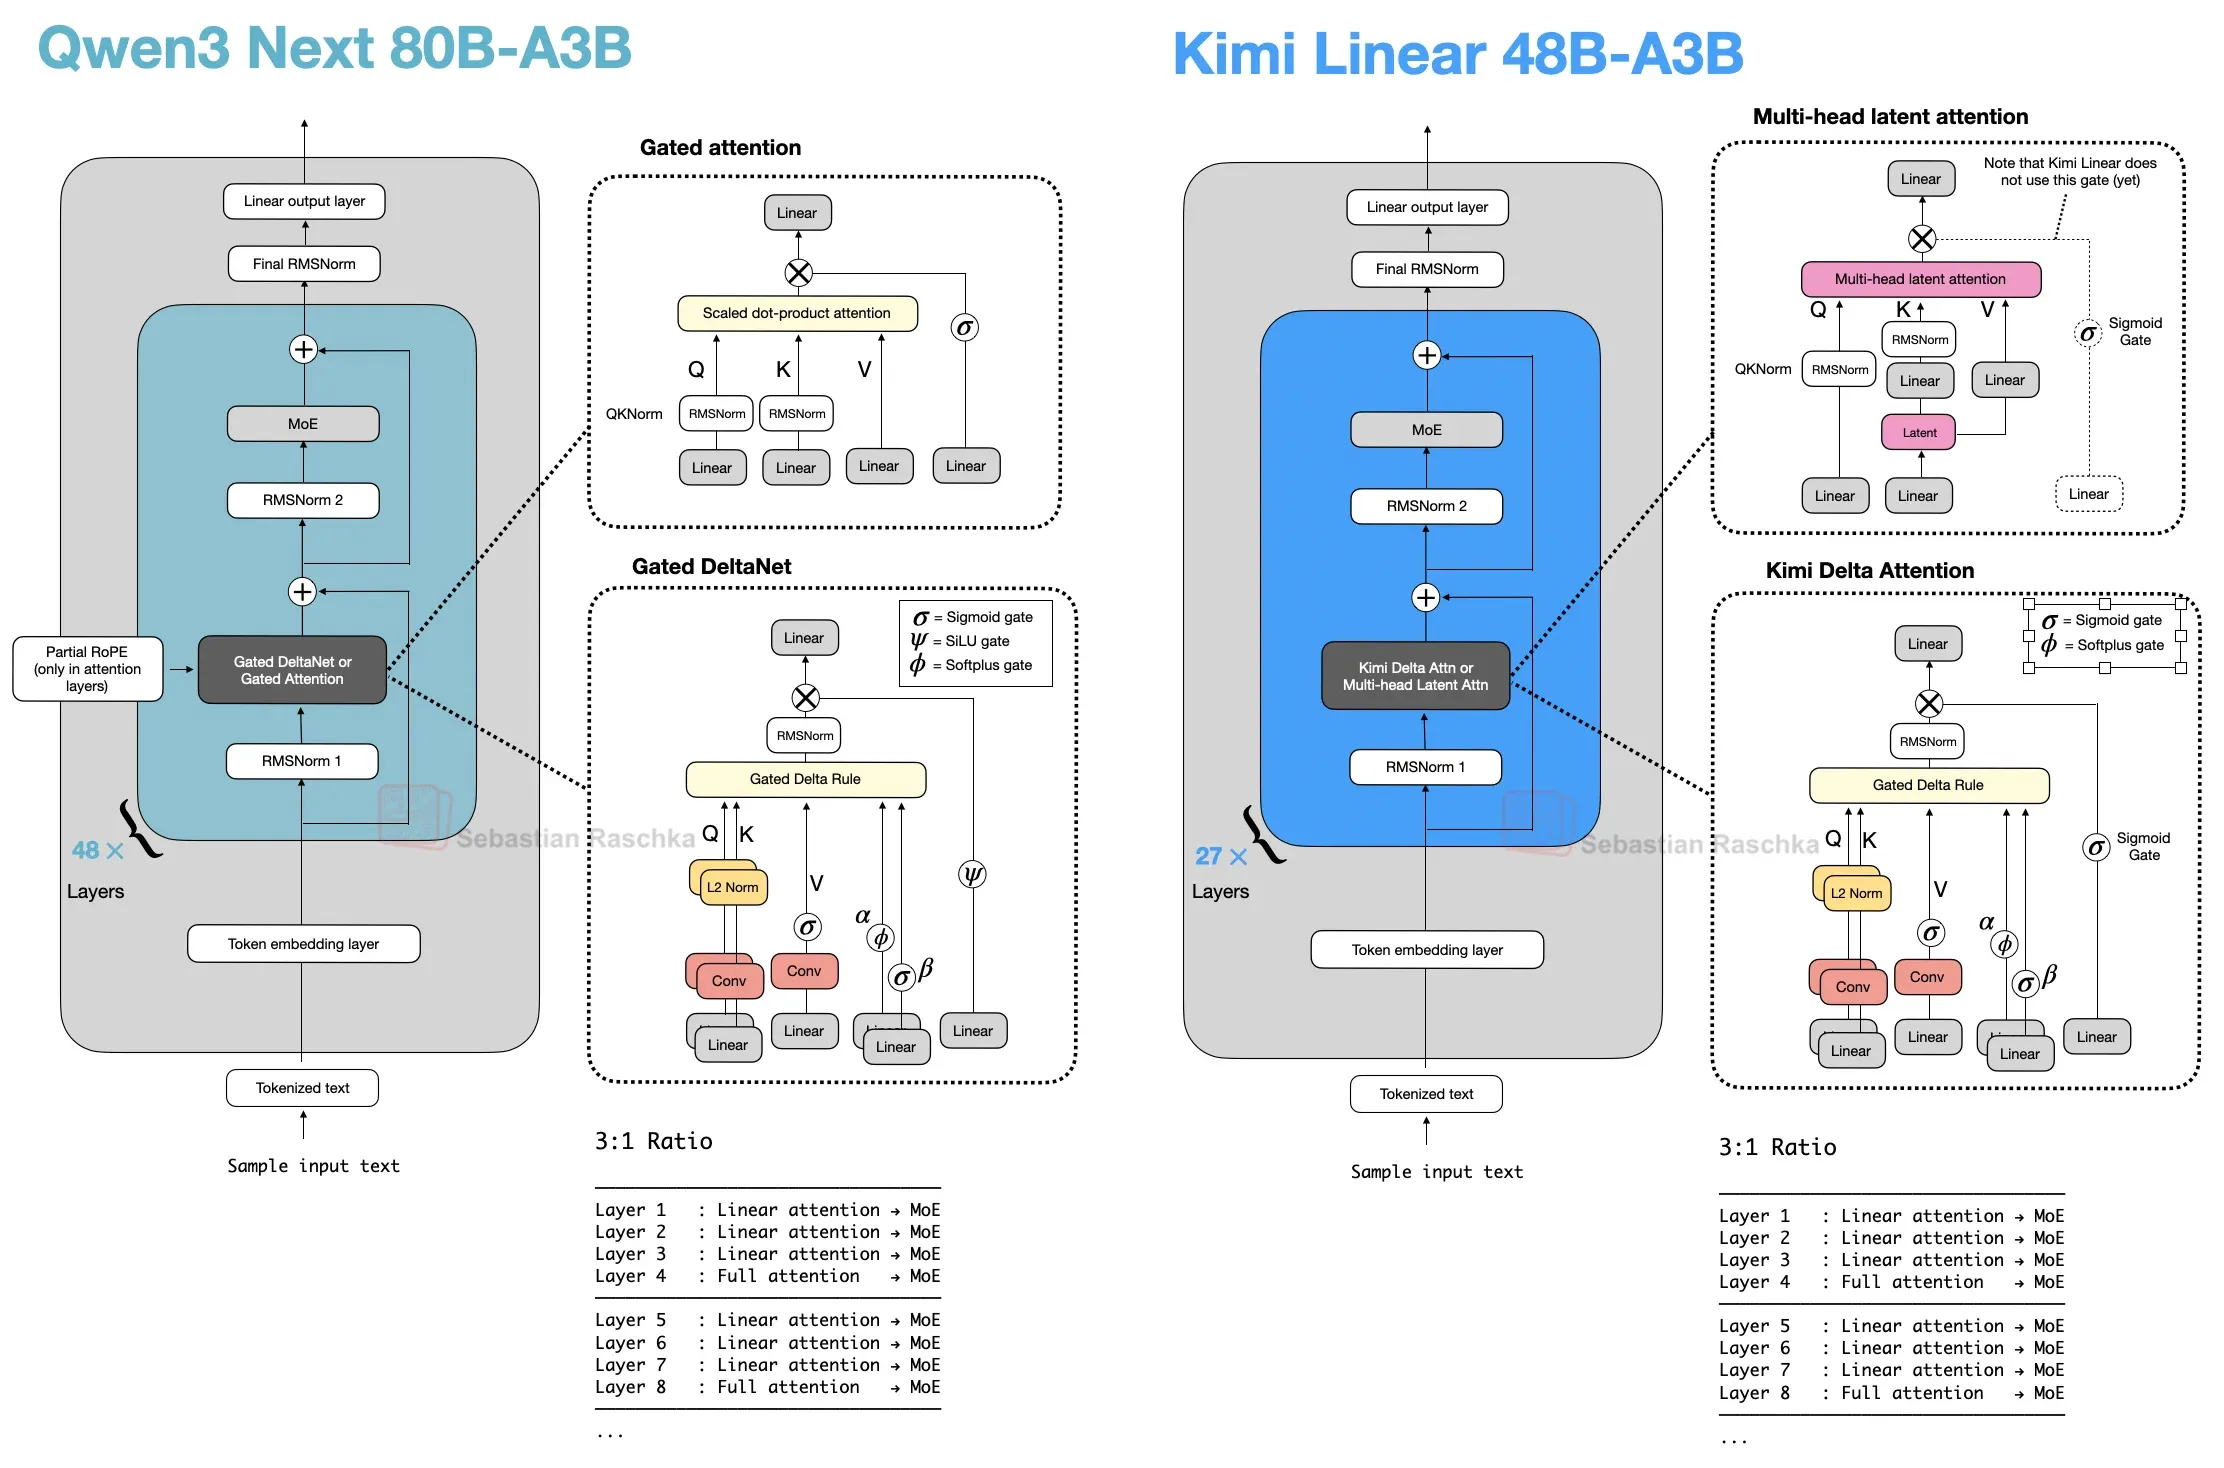
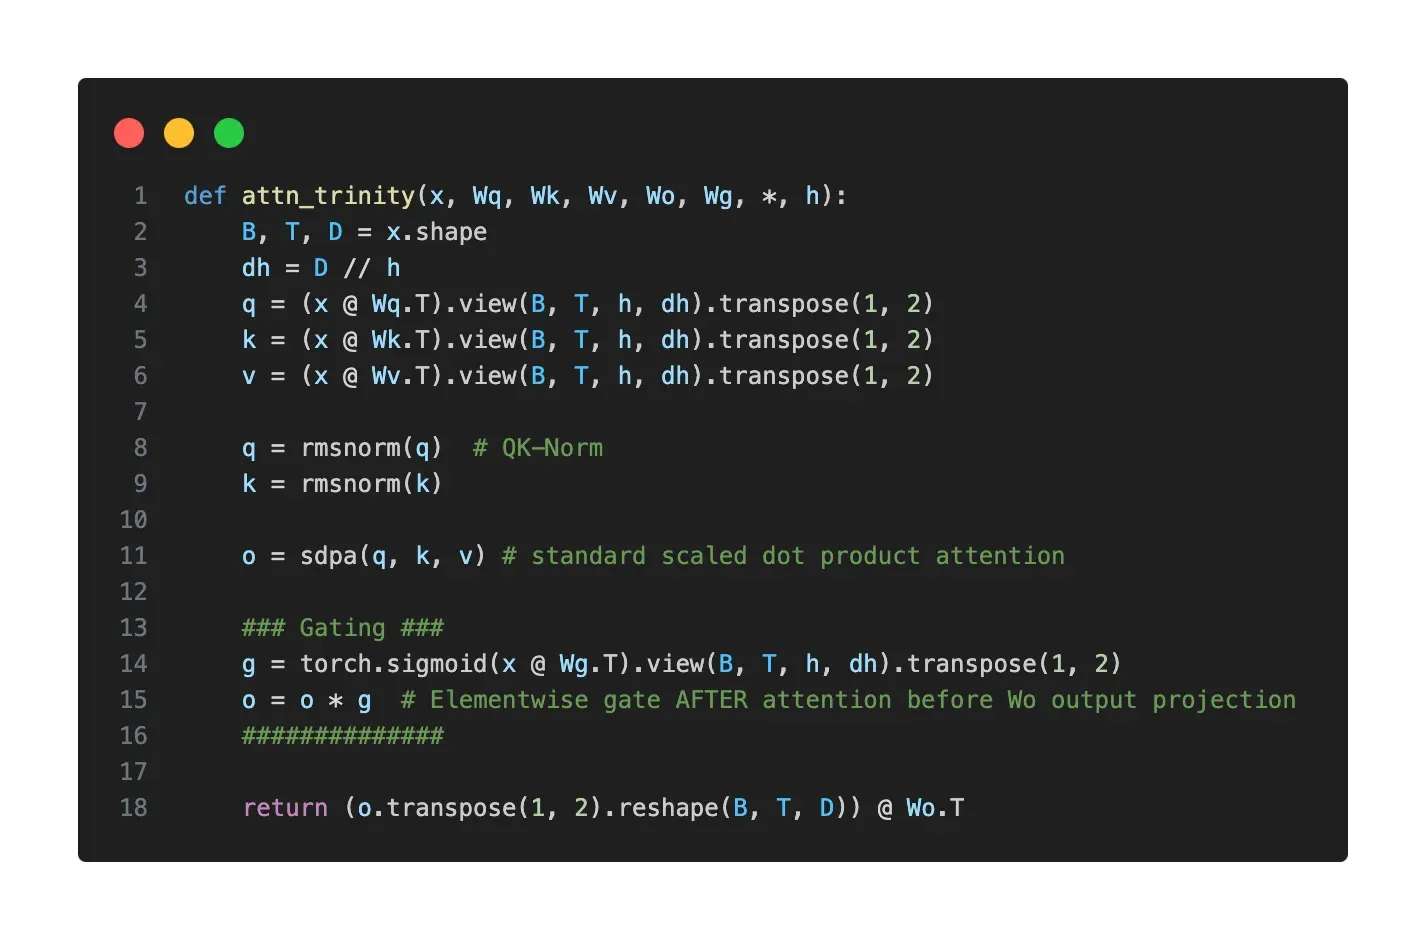
Gated Attention 不是独立路线,而是在全注意力输出进入残差前加入 sigmoid 门,来源是 arXiv:2505.06708。它用于缓解 attention sink 和过大的激活值。Qwen 系、Step 3.5 Flash(head-wise 门控)和 Trinity 均采用了相关门控设计。
FFN:MoE 的细粒度化
表格里 Sparse 的 30 个模型全走 MoE 路线,而 MoE 的当代形态基本由 DeepSeekMoE 定义(arXiv:2401.06066):把大专家拆成更多小专家(细粒度),再加一个每个 token 必过的共享专家。小专家提升组合表达的灵活性,共享专家承接通用知识,避免每个路由专家都去学一遍常见模式。
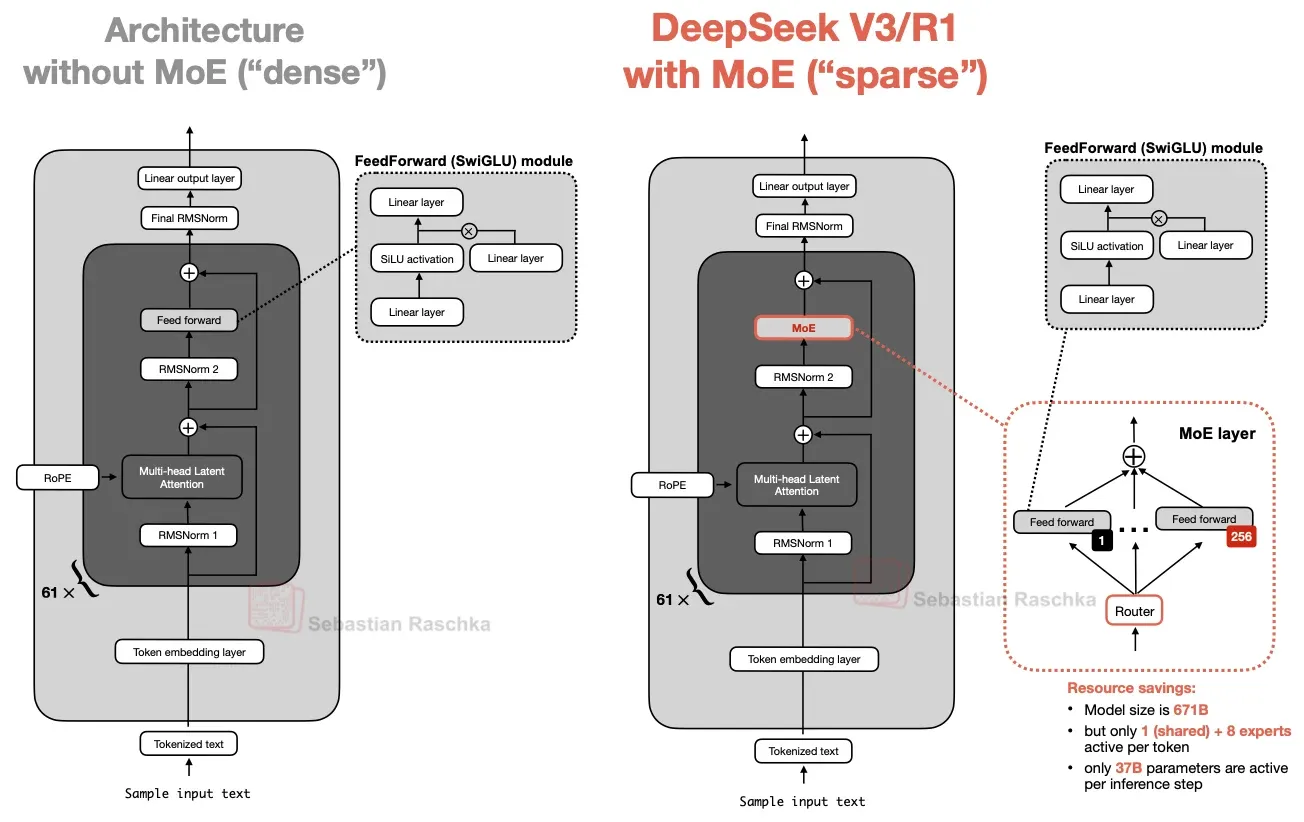
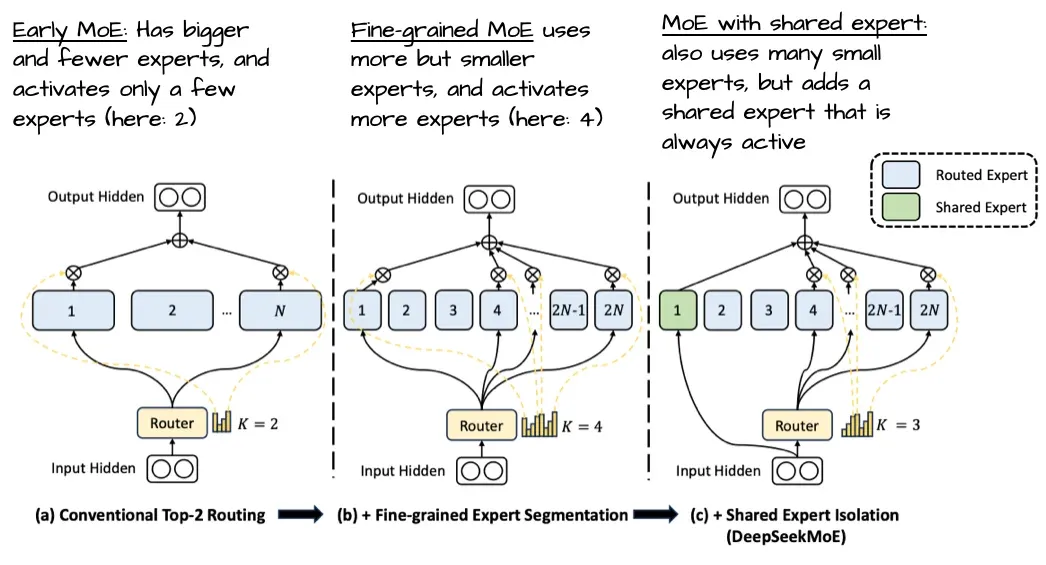
本表中的专家配置差异较大:GLM-5 每层 256 个专家(8 路由 + 1 共享),Step 3.5 Flash 为 288 个(top-8),Nemotron 3 Super 为 512 个(top-22),Kimi K3 进一步拉开稀疏度到 896 个(top-16 + 2 共享)。也有采用较少、大型专家的模型,例如 gpt-oss。专家数量需要结合部署形态和推理吞吐评估,不能单独用于判断优劣。
另一个细节是,部分 MoE 模型在开头绕开常规路由:GLM-5、Step 3.5 Flash 的前 3 层是纯稠密 FFN;Ling 3.0-flash 与 DeepSeek V4 分别为前 2 层和前 3 层做了特殊处理(前者纯稠密,后者使用由 token ID 哈希确定目标专家的 MoE);Kimi K3 则只有第 1 层是稠密。它们的共同目标是降低早期层引入路由不稳定性的风险,但具体实现并不相同。
残差:34 家 RC,mHC 有了第二个用户
表格里最扎眼的差异在残差列。34 个模型用最普通的残差连接(RC),DeepSeek V4 系列换成了 mHC(流形约束超连接)。
故事从 Hyper-Connections(字节,2024)开始:把单一的残差流加宽成 n 路,层与层之间的连接模式变成可学习的混合矩阵,表达力更强。但 HC 的混合矩阵是自由参数,破坏了残差连接的恒等映射性质,深了之后训练发散。
DeepSeek 的 mHC(2025 年 12 月论文)为混合矩阵加入流形约束:采用 Sinkhorn-Knopp 算法迭代 20 轮,将其投影到双随机矩阵空间(Birkhoff 多面体),以恢复恒等映射性质并提升训练稳定性。V4 是 mHC 的首个前沿规模部署,配置为 hc_mult: 4(4 路残差流)和 hc_sinkhorn_iters: 20。论文将稳定性机制描述为经验性结果,并未给出理论保证。
下半年出现了两个新信号。一是 GLM-5.3-Flash 成为第一家跟进 mHC 的外部团队,配置与 V4 完全一致(同样 hc_mult: 4、Sinkhorn 20 轮);二是 Qwen3.8-Flash-Next 的 Gated Residual 也是一个 4 路残差流,外加数据依赖的逐元素读门和逐分支标量写门——分支数与 mHC 不谋而合,但没提双随机约束。Kimi K3 的 Attention Residuals(AttnRes)则是另一个方向,官方资料目前只有一句话提及,细节留待技术报告。
激活函数:SwiGLU 的天下,Gemma 的坚持
在本表样本中,Gemma 4 的五个条目使用 GELU,Nemotron 3.5 Lightning 使用 ReLU²,其余条目的激活函数标为 SiLU;Kimi K3 的配置文件里出现了新的 situ 激活,官方未展开说明。仅凭激活函数一列无法比较 SwiGLU 与 GeGLU 的整体效果;这类差异还取决于 FFN 结构、训练数据和优化配置。
把表格合上看:三条路线
从这 39 个样本的公开架构资料中,可以归纳出三类主要组合:
压缩注意力路线:Kimi K2.5/K2.6、GLM-5/5.1/5.2、Mistral Small 4、Sarvam 105B 和 Ling 2.x 采用 MLA 或 MLA 与其他机制的组合。DeepSeek V3.2 在 MLA 基础上采用 DSA;DeepSeek V4 则采用 CSA/HCA;MiniMax-M3 的 MSA 与 GLM-5.3-Flash 的线性+DSA 说明这条路线还在继续分化。共同目标是降低长上下文的 KV cache 与注意力计算成本,但具体机制并不相同。
线性注意力混合路线:Qwen3.5/3.6/3.8 均以 3:1 的比例混合 Gated DeltaNet 与门控注意力(包括 27B Dense 版本,Flash-Next 把全注意力层换成 QSA);Kimi K3 与 Ling 3.0 把 KDA 带进旗舰和端侧;Nemotron 系继续走 Mamba-2 混合。上半年「MiniMax 独苗线性、Kimi 坚守 MLA」的格局,到 8 月已经完全反转。
经典注意力组合:Gemma 4 采用 GQA、5:1 SWA 和 Sandwich Norm。其效果应以明确版本、日期和评测条件的基准为准;本文不以动态排行榜比较不同参数规模模型的能力。Step 3.x 的 GQA+SWA 与 Nanbeige 的标准 Transformer 配置则表明,架构选择仍有多种可行路径。
在这 39 个样本中,Pre-Norm 与 Post-Norm、MLA 与 GQA、全注意力与线性混合等位置都已有多种成熟选项。这一观察只描述公开的架构组合,不能单独推出基础架构、数据、训练配方或后训练在模型能力中的相对重要性。DeepSeek V4 与 GLM-5.3-Flash 先后采用 mHC,说明,残差连接仍是值得继续验证的架构方向。
参考
汇总用的主要来源:
- Sebastian Raschka, The Big LLM Architecture Comparison(2025-07 发布,2026-04 更新至 Gemma 4)
- Sebastian Raschka, A Dream of Spring for Open-Weight LLMs(2026 年 1-2 月十个架构的补充)
- Raschka 的 LLM Architecture Gallery(逐模型架构卡片与 config 对照)
论文与模型资料(按文中出现顺序):
目录
评论
评论功能已就位但尚未启用:在
src/config.ts的giscus字段中填入 repo / repoId / category / categoryId(到 giscus.app 用公开 GitHub 仓库生成)后,评论框会自动出现在这里。